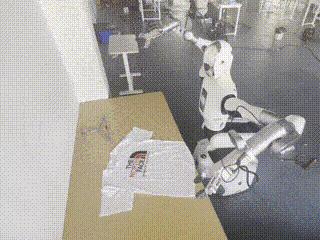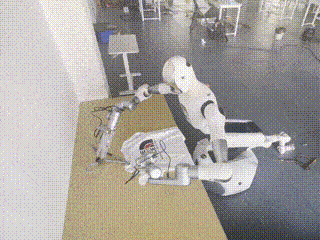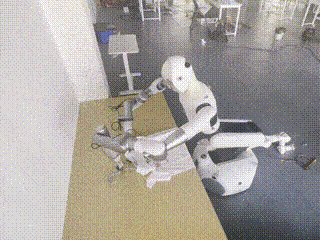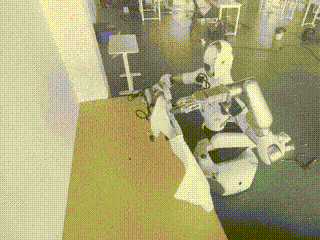
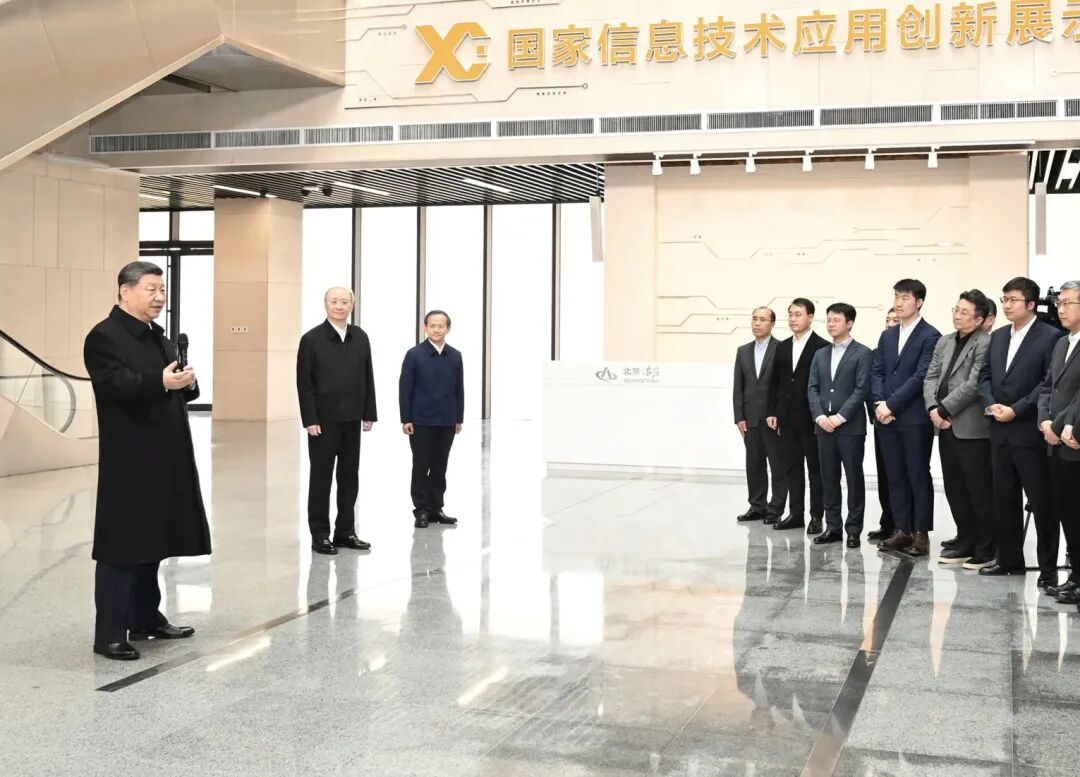
On February 9, 2026, President Xi Jinping conducted an
inspection of the Galbot G1 robot in Beijing and met with Prof.
He Wang, together with other leaders in technology innovation.
                @inproceedings{
                chen2026foldnetxx,
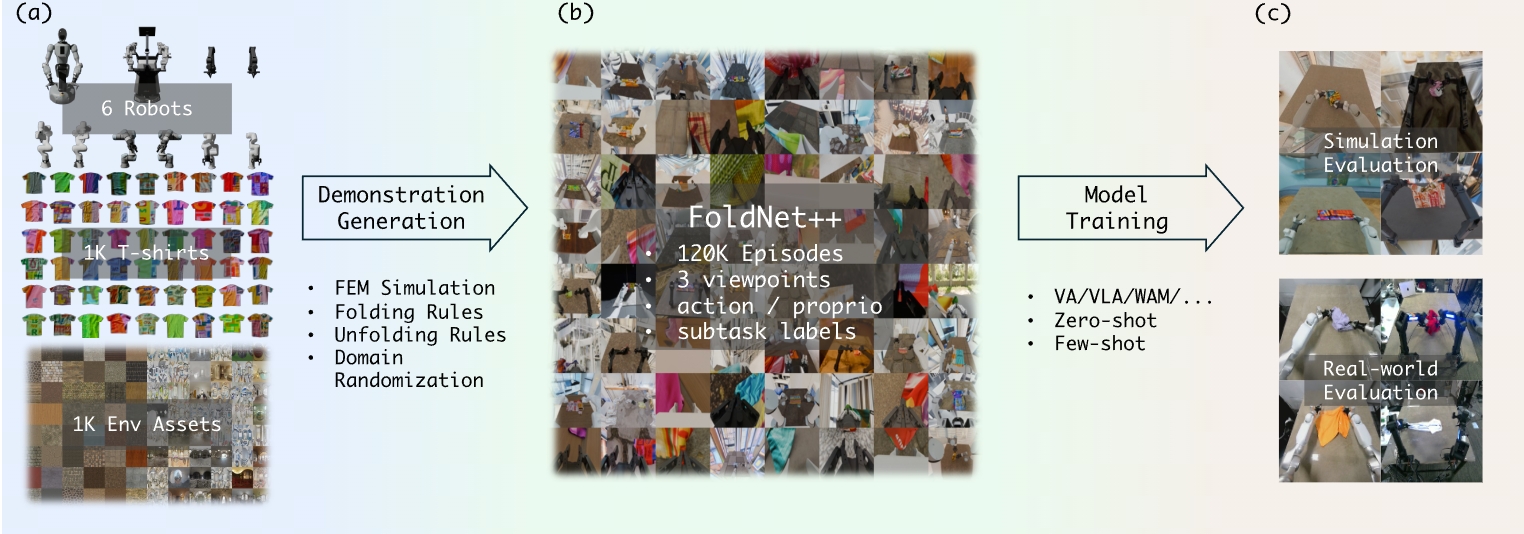
                title={FoldNet++: a Large-Scale Synthetic Dataset for Robotic T-Shirt Folding and Unfolding},
                author={Yuxing Chen and Zhiyuan Wei and Bowen Xiao and Zhizheng Zhang and He Wang},
                booktitle={10th Annual Conference on Robot Learning},
                year={2026},
                url={https://openreview.net/forum?id=JMcC5JoPKD}
                }
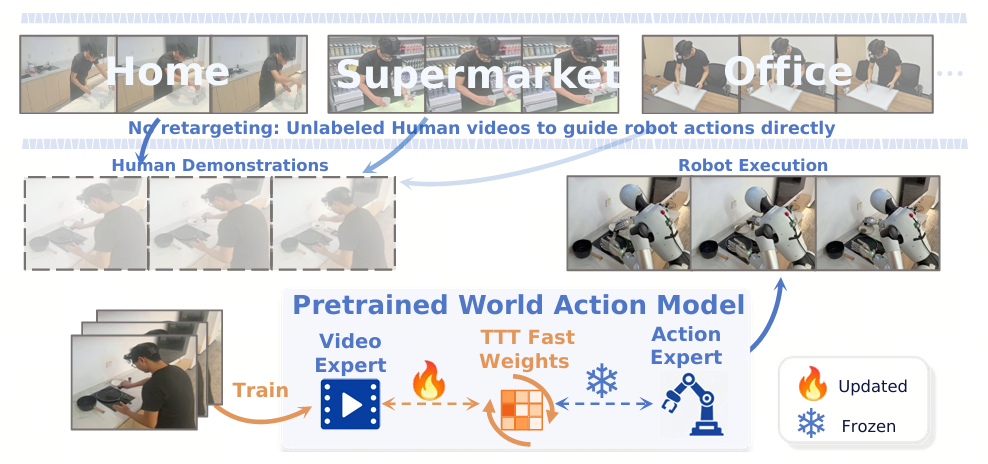
WAM-TTT: Steering World-Action Models by Watching Human Play at
Test Time
                @misc{feng2026wamtttsteeringworldactionmodels,
                      title={WAM-TTT: Steering World-Action Models by Watching Human Play at Test Time},
                      author={Yusen Feng and Bingchen Han and Jiangran Lyu and Kai Liu and Yixin Zheng and Yuxuan Wan and Weiheng Liu and Sun Han and Ruiqin Li and Yulong Zhang and Fangfu Liu and Xuesong Shi and Libin Liu and Yizhou Wang and Zhizheng Zhang and He Wang},
                      year={2026},
                      eprint={2607.06988},
                      archivePrefix={arXiv},
                      primaryClass={cs.RO},
                      url={https://arxiv.org/abs/2607.06988},
                }
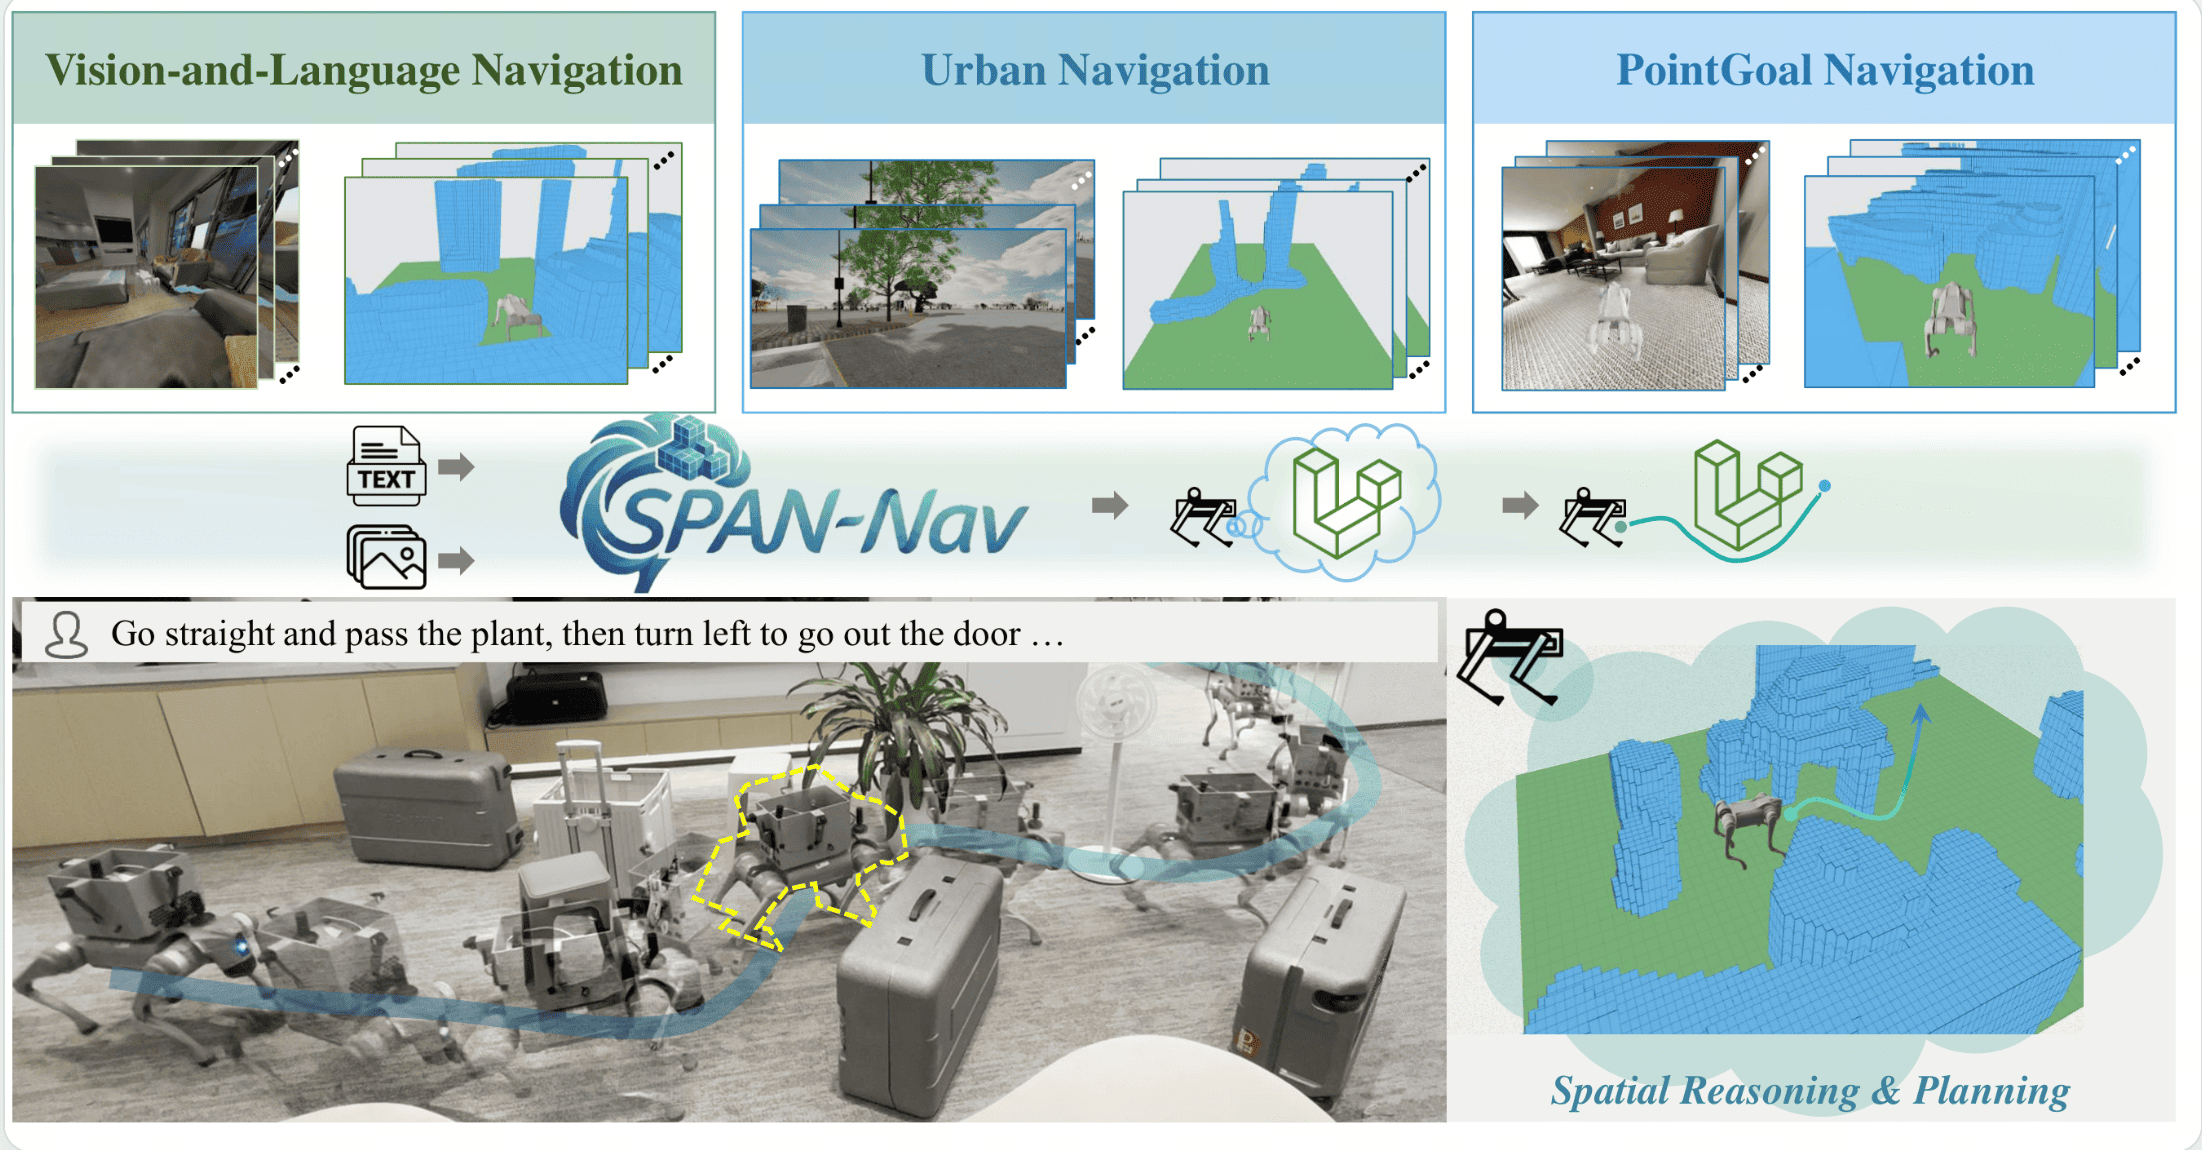
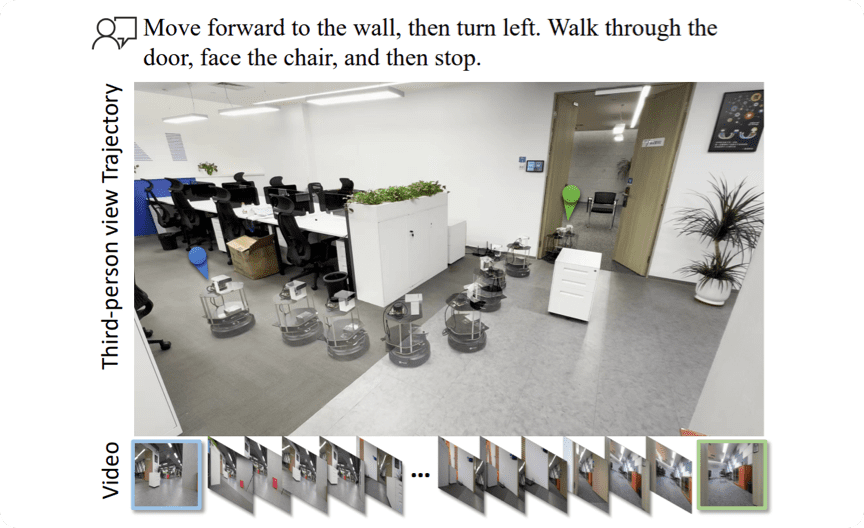
SPAN-Nav: Generalized Spatial Awareness for Versatile
Vision-Language Navigation
Jiahang Liu∗, Tianyu Xu∗, Jiawei Chen∗, Lu Yue∗, Jiazhao Zhang∗,
Zhiyong Wang∗, Minghan Li, Qisheng Zhao, Anqi Li, Qi Su,
Zhizheng Zhang†, He Wang†
              @misc{liu2026spannavgeneralizedspatialawareness,
                title={SPAN-Nav: Generalized Spatial Awareness for Versatile Vision-Language Navigation},
                author={Jiahang Liu and Tianyu Xu and Jiawei Chen and Lu Yue and Jiazhao Zhang and Zhiyong Wang and Minghan Li and Qisheng Zhao and Anqi Li and Qi Su and Zhizheng Zhang and He Wang},
                year={2026},
                eprint={2603.09163},
                archivePrefix={arXiv},
                primaryClass={cs.RO},
                url={https://arxiv.org/abs/2603.09163},
              }
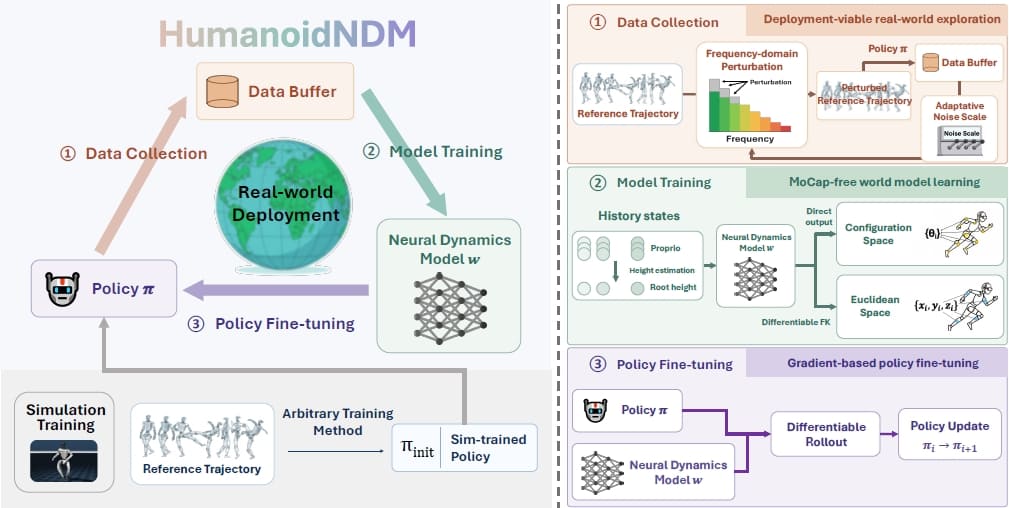
HumanoidNDM: Closing the Training-Deployment Gap of Motion
Tracking via Humanoid Neural Dynamics Model
Chao Chen∗, Zhenrong Wang∗, Jilong Wang, Yusen Feng, Jiangran
Lyu, Li Yi, He Wang†
CoRL 2026
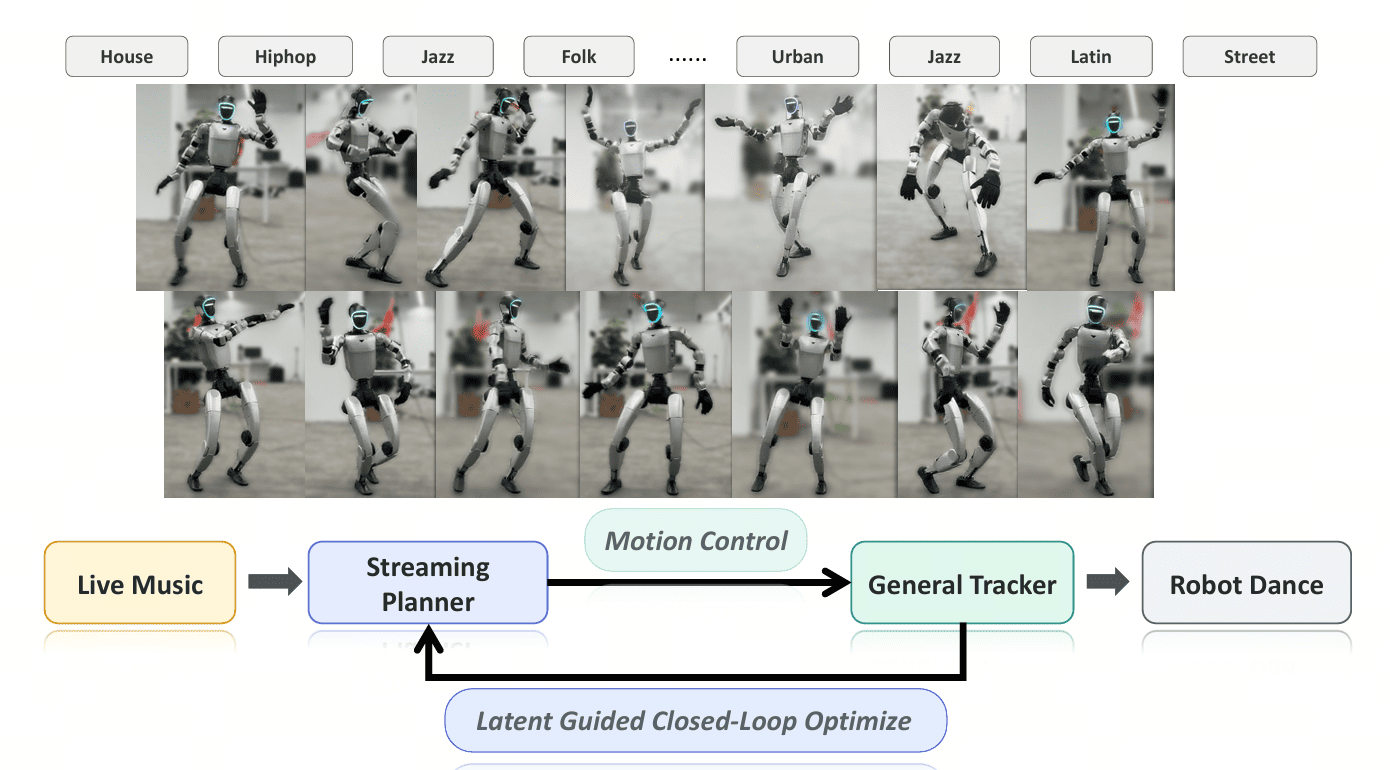
InfiniDanceRobot: A Streaming and Closed-Loop Music-driven Dance
Generation for Humanoid Robot
Jinlu Zhang∗, Chenguang Li, Chunze Lin, Yu-Hui Wen, Liping Jing,
He Wang†, Li Yi†, Yizhou Wang†
CoRL 2026
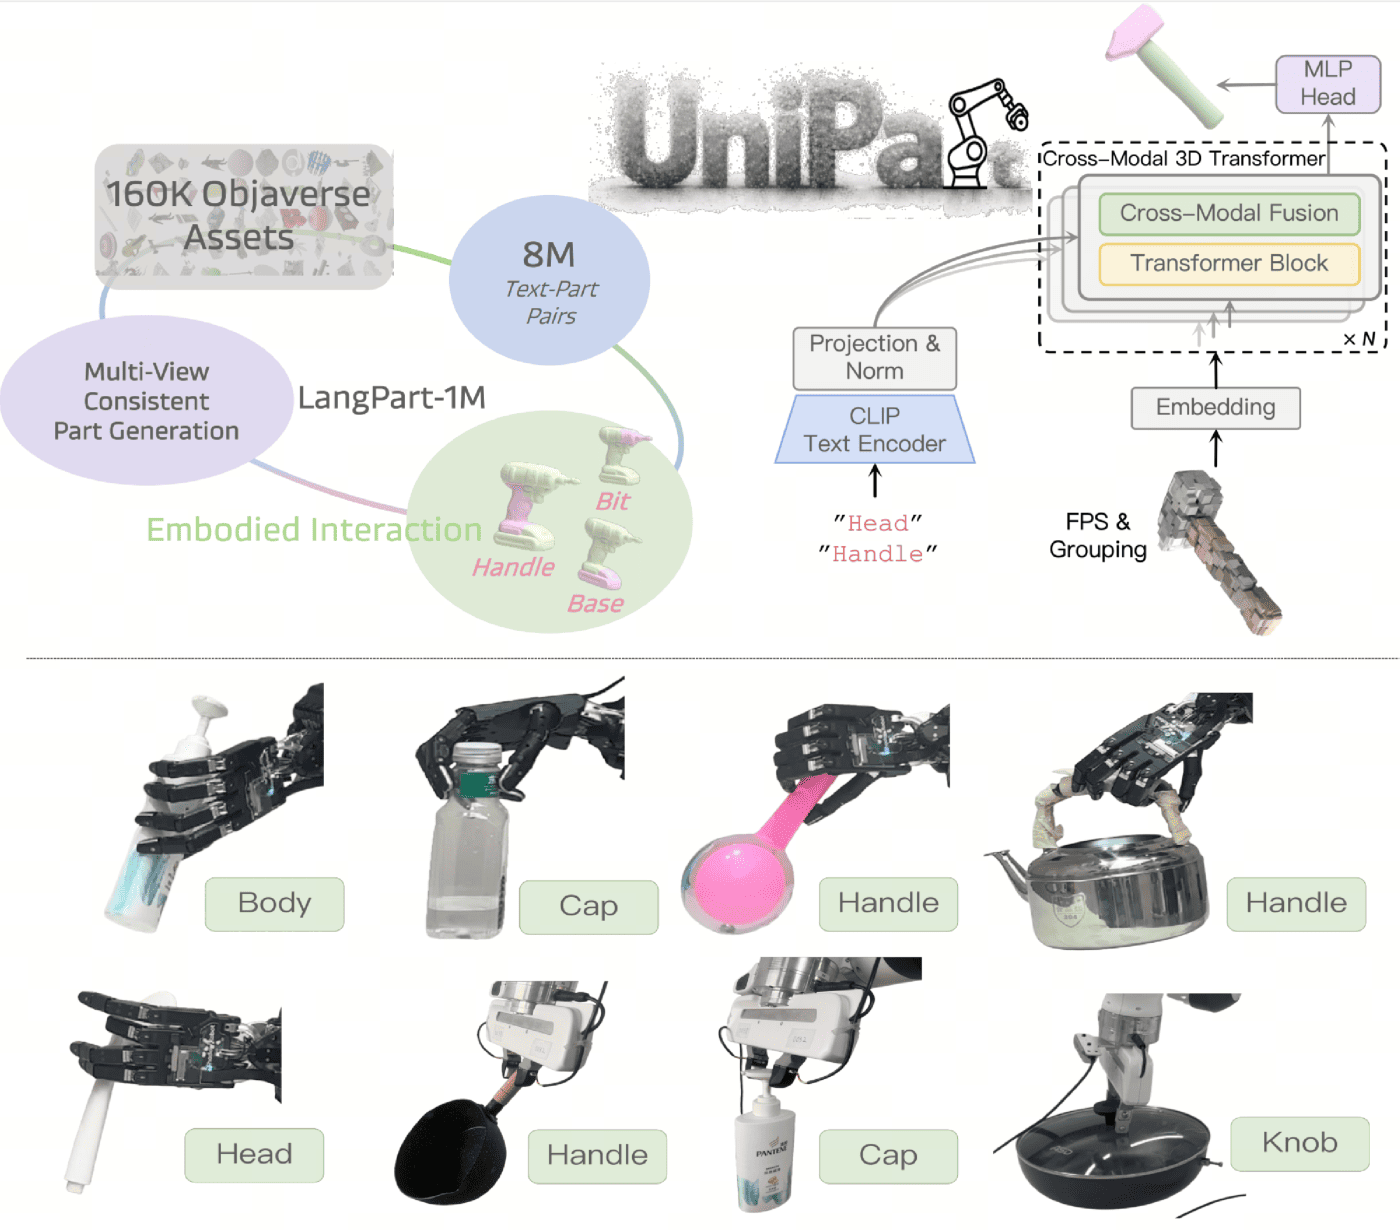
UniPart: Towards Zero-shot Language-Grounded 3D Part
Segmentation for Embodied Interaction
Xinqiang Yu*, Zekun Qi*, Jiawei He, Wenyao Zhang, Xuchuan Chen,
Guocai Yao, Li Yi†, Zhaoxiang Zhang†, He Wang†
              @inproceedings{yu2026unipart,
                title     = {UniPart: Towards Zero-shot Language-Grounded 3D Part Segmentation
                            for Embodied Interaction},
                author    = {Xinqiang Yu and Zekun Qi and Jiawei He and Wenyao Zhang and
                            Xuchuan Chen and Guocai Yao and Li Yi and Zhaoxiang Zhang and He Wang},
                booktitle = {European Conference on Computer Vision (ECCV)},
                year      = {2026}
              }
MM-Nav: Multi-View VLA Model for Robust Visual Navigation via
Multi-Expert Learning
              @article{xu2025mm,
                title={MM-Nav: Multi-View VLA Model for Robust Visual Navigation via Multi-Expert Learning},
                author={Xu, Tianyu and Chen, Jiawei and Zhang, Jiazhao and Zhang, Wenyao and Qi, Zekun and Li, Minghan and Zhang, Zhizheng and Wang, He},
                journal={arXiv preprint arXiv:2510.03142},
                year={2025}
              }
Show More
HumanTracker: Towards Comprehensive and Human-Aligned Motion
Tracking Benchmark
                @misc{liu2026humantrackercomprehensivehumanalignedmotion,
                      title={HumanTracker: Towards Comprehensive and Human-Aligned Motion Tracking Benchmark},
                      author={Dairu Liu and Zekun Qi and Jiayu Zeng and Ruixi Yu and Yu Guan and Yintianrun Zhang and Xuchuan Chen and Sikai Liang and Zekai Li and Chenghuai Lin and Xinqiang Yu and Wenyao Zhang and He Wang and Li Yi},
                      year={2026},
                      eprint={2608.13555},
                      archivePrefix={arXiv},
                      primaryClass={cs.RO},
                      url={https://arxiv.org/abs/2608.13555},
                }
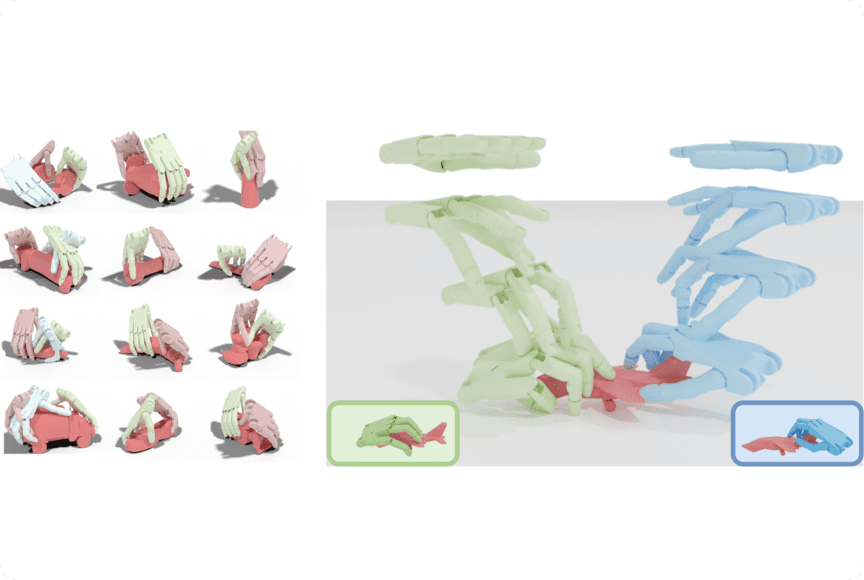
GraspADMM: Improving Dexterous Grasp Synthesis via ADMM
Optimization
Liangwang Ruan*, Jiayi Chen*, He Wang†, Baoquan Chen†
                @misc{ruan2026graspadmmimprovingdexterousgrasp,
                    title={GraspADMM: Improving Dexterous Grasp Synthesis via ADMM Optimization},
                    author={Liangwang Ruan and Jiayi Chen and He Wang and Baoquan Chen},
                    year={2026},
                    eprint={2603.13832},
                    archivePrefix={arXiv},
                    primaryClass={cs.RO},
                    url={https://arxiv.org/abs/2603.13832},
              }
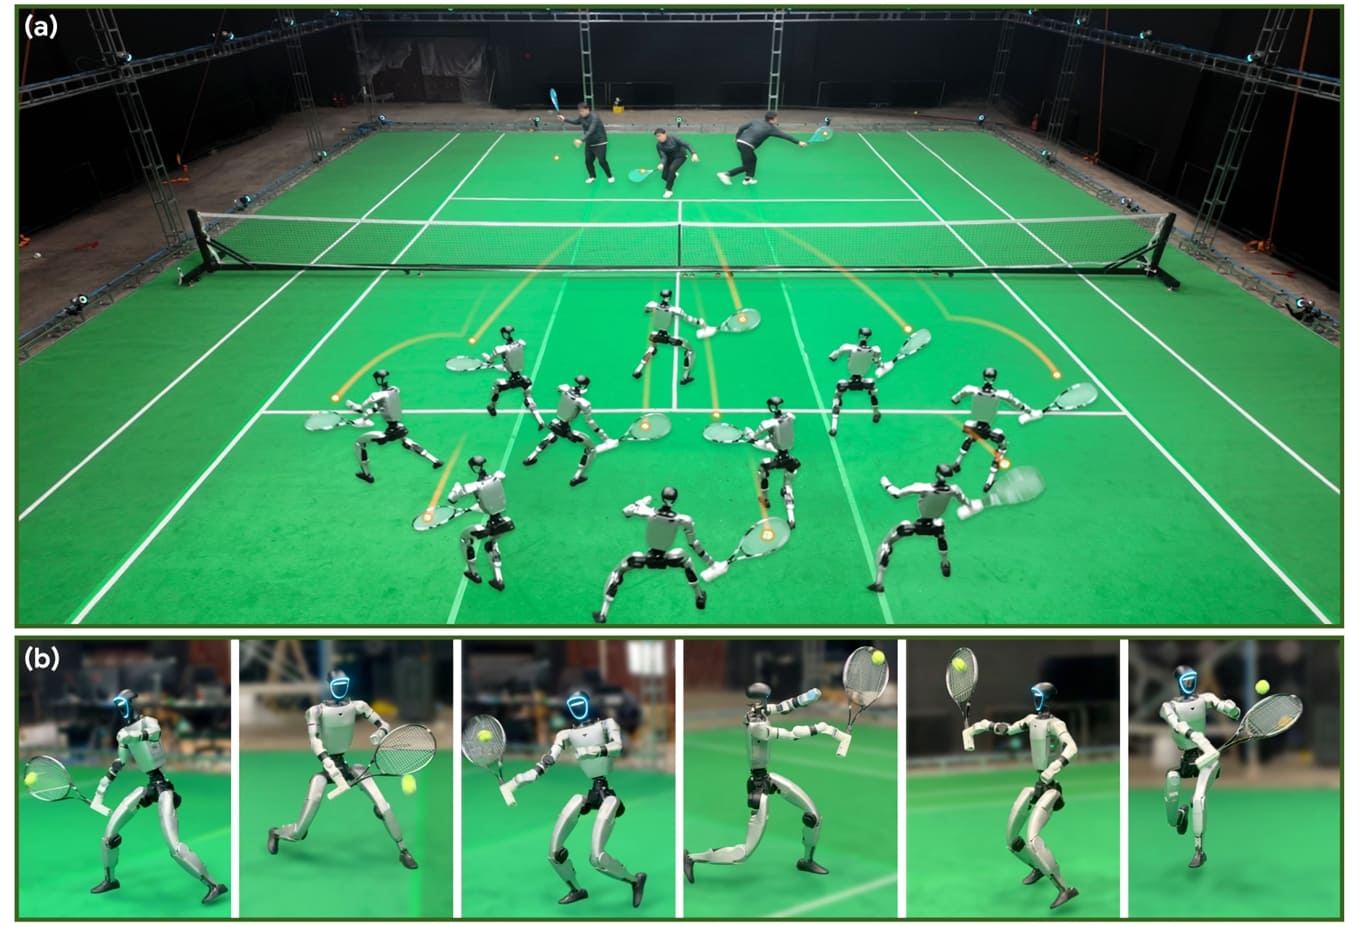
Learning Athletic Humanoid Tennis Skills from Imperfect
Human Motion Data
Zhikai Zhang*, Haofei Lu*, Yunrui Lian*, Ziqing Chen, Yun
Liu, Chenghuai Lin, Han Xue, Zicheng Zeng, Zekun Qi, Shaolin
Zheng, Qing Luan, Jingbo Wang, Junliang Xing,
He Wang†, Li Yi†
                @misc{zhang2026learningathletichumanoidtennis,
                  title={Learning Athletic Humanoid Tennis Skills from Imperfect Human Motion Data},
                  author={Zhikai Zhang and Haofei Lu and Yunrui Lian and Ziqing Chen and Yun Liu and Chenghuai Lin and Han Xue and Zicheng Zeng and Zekun Qi and Shaolin Zheng and Qing Luan and Jingbo Wang and Junliang Xing and He Wang and Li Yi},
                  year={2026},
                  eprint={2603.12686},
                  archivePrefix={arXiv},
                  primaryClass={cs.RO},
                  url={https://arxiv.org/abs/2603.12686},
                }
HDFlow: Hierarchical Diffusion-Flow Planning for
Long-horizon Tasks
              @misc{gireesh2026hdflowhierarchicaldiffusionflowplanning,
                title={HDFlow: Hierarchical Diffusion-Flow Planning for Long-horizon Tasks},
                author={Nandiraju Gireesh and Yuanliang Ju and Chaoyi Xu and Weiheng Liu and Yuxuan Wan and He Wang},
                year={2026},
                eprint={2605.04525},
                archivePrefix={arXiv},
                primaryClass={cs.RO},
                url={https://arxiv.org/abs/2605.04525},
              }
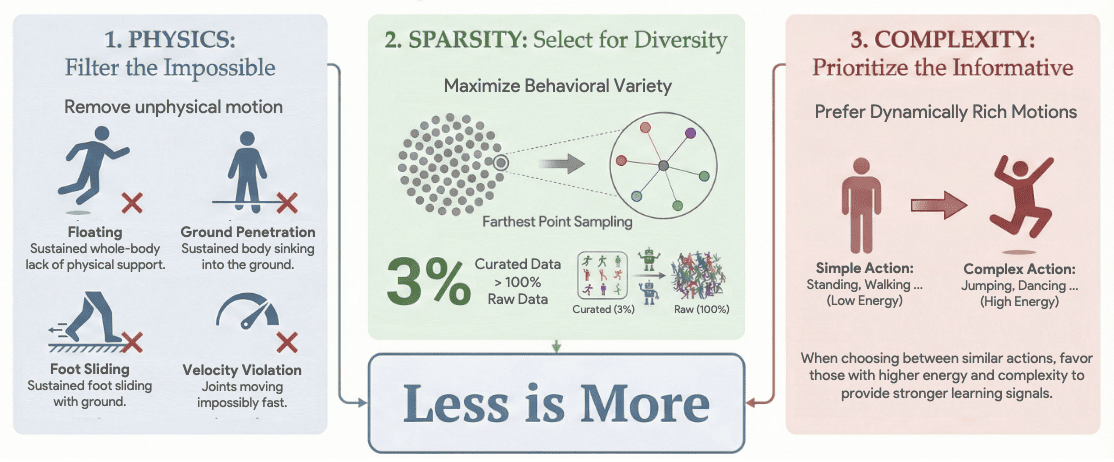
LIMMT: Less is More for Motion Tracking
Yu Guan*, Zekun Qi*, Chenghuai Lin, Xuchuan Chen, Dairu Liu,
Wenyao Zhang, Jilong Wang, Xinqiang Yu,
He Wang†, Li Yi†
                @inproceedings{limmt26,
                  title={LIMMT: Less is More for Motion Tracking},
                  author={Guan, Yu and Qi, Zekun and Lin, Chenghuai and Chen, Xuchuan and Liu, Dairu and Zhang, Wenyao and Wang, Jilong and Yu, Xinqiang and Wang, He and Yi, Li},
                  booktitle={International Conference on Machine Learning (ICML) },
                  year={2026}
                }
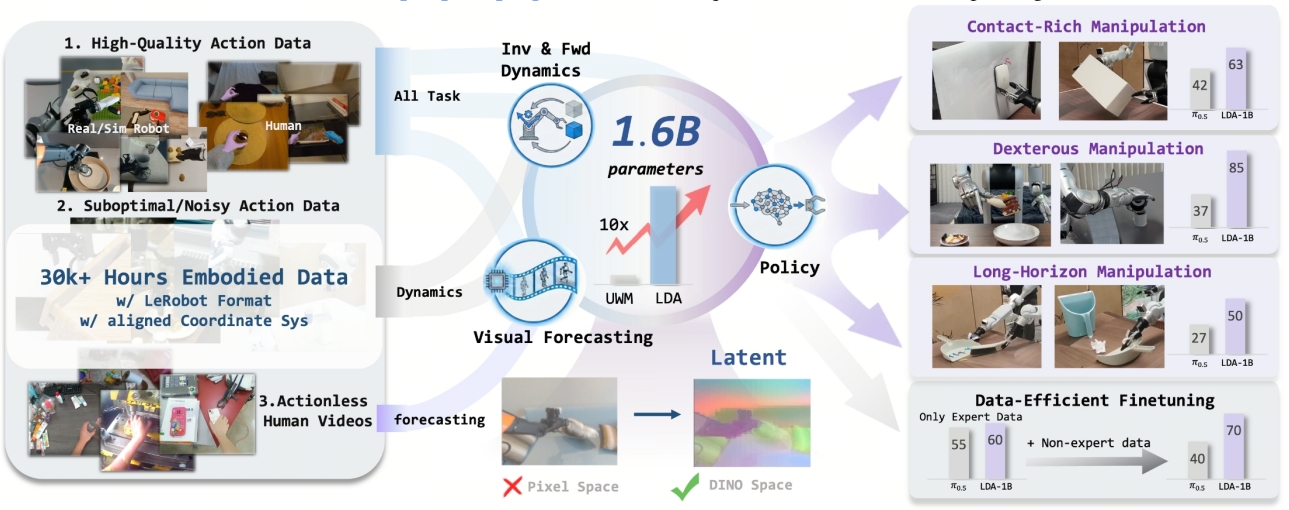
LDA-1B: Scaling Latent Dynamics Action Model via Universal
Embodied Data Ingestion
                @article{lyu2026lda,
                  title={LDA-1B: Scaling Latent Dynamics Action Model via Universal Embodied Data Ingestion},
                  author={Lyu, Jiangran and Liu, Kai and Zhang, Xuheng and Liao, Haoran and Feng, Yusen and Zhu, Wenxuan and Shen, Tingrui and Chen, Jiayi and Zhang, Jiazhao and Dong, Yifei and others},
                  journal={arXiv preprint arXiv:2602.12215},
                  year={2026}
                }
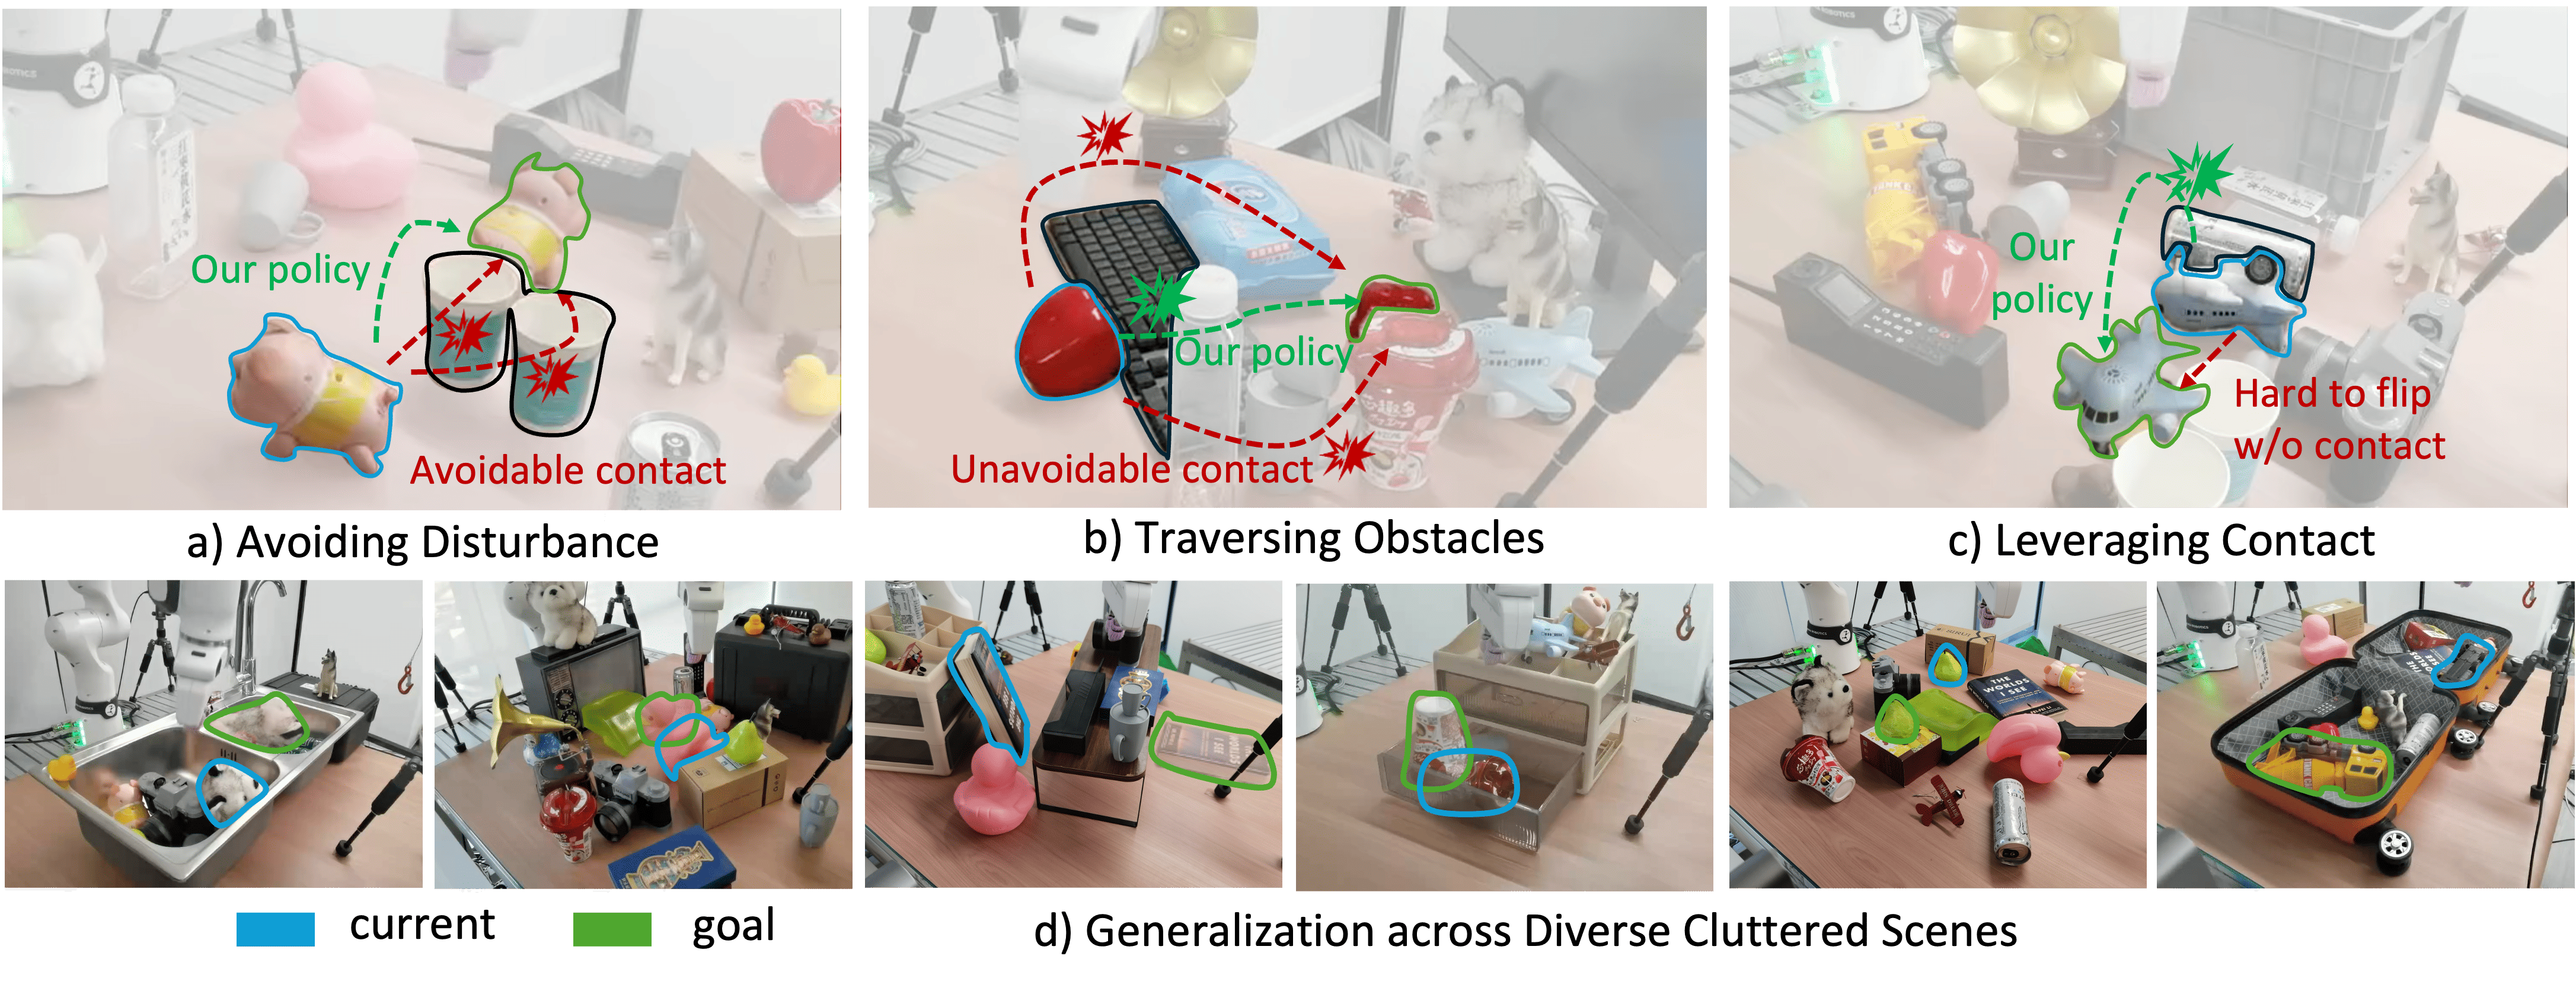
Emerging Extrinsic Dexterity in Cluttered Scenes via
Dynamics-aware Policy Learning
                @misc{zheng2026emergingextrinsicdexteritycluttered,
                      title={Emerging Extrinsic Dexterity in Cluttered Scenes via Dynamics-aware Policy Learning},
                      author={Yixin Zheng and Jiangran Lyu and Yifan Zhang and Jiayi Chen and Mi Yan and Yuntian Deng and Xuesong Shi and Xiaoguang Zhao and Yizhou Wang and Zhizheng Zhang and He Wang},
                      year={2026},
                      eprint={2603.09882},
                      archivePrefix={arXiv},
                      primaryClass={cs.RO},
                      url={https://arxiv.org/abs/2603.09882},
                }
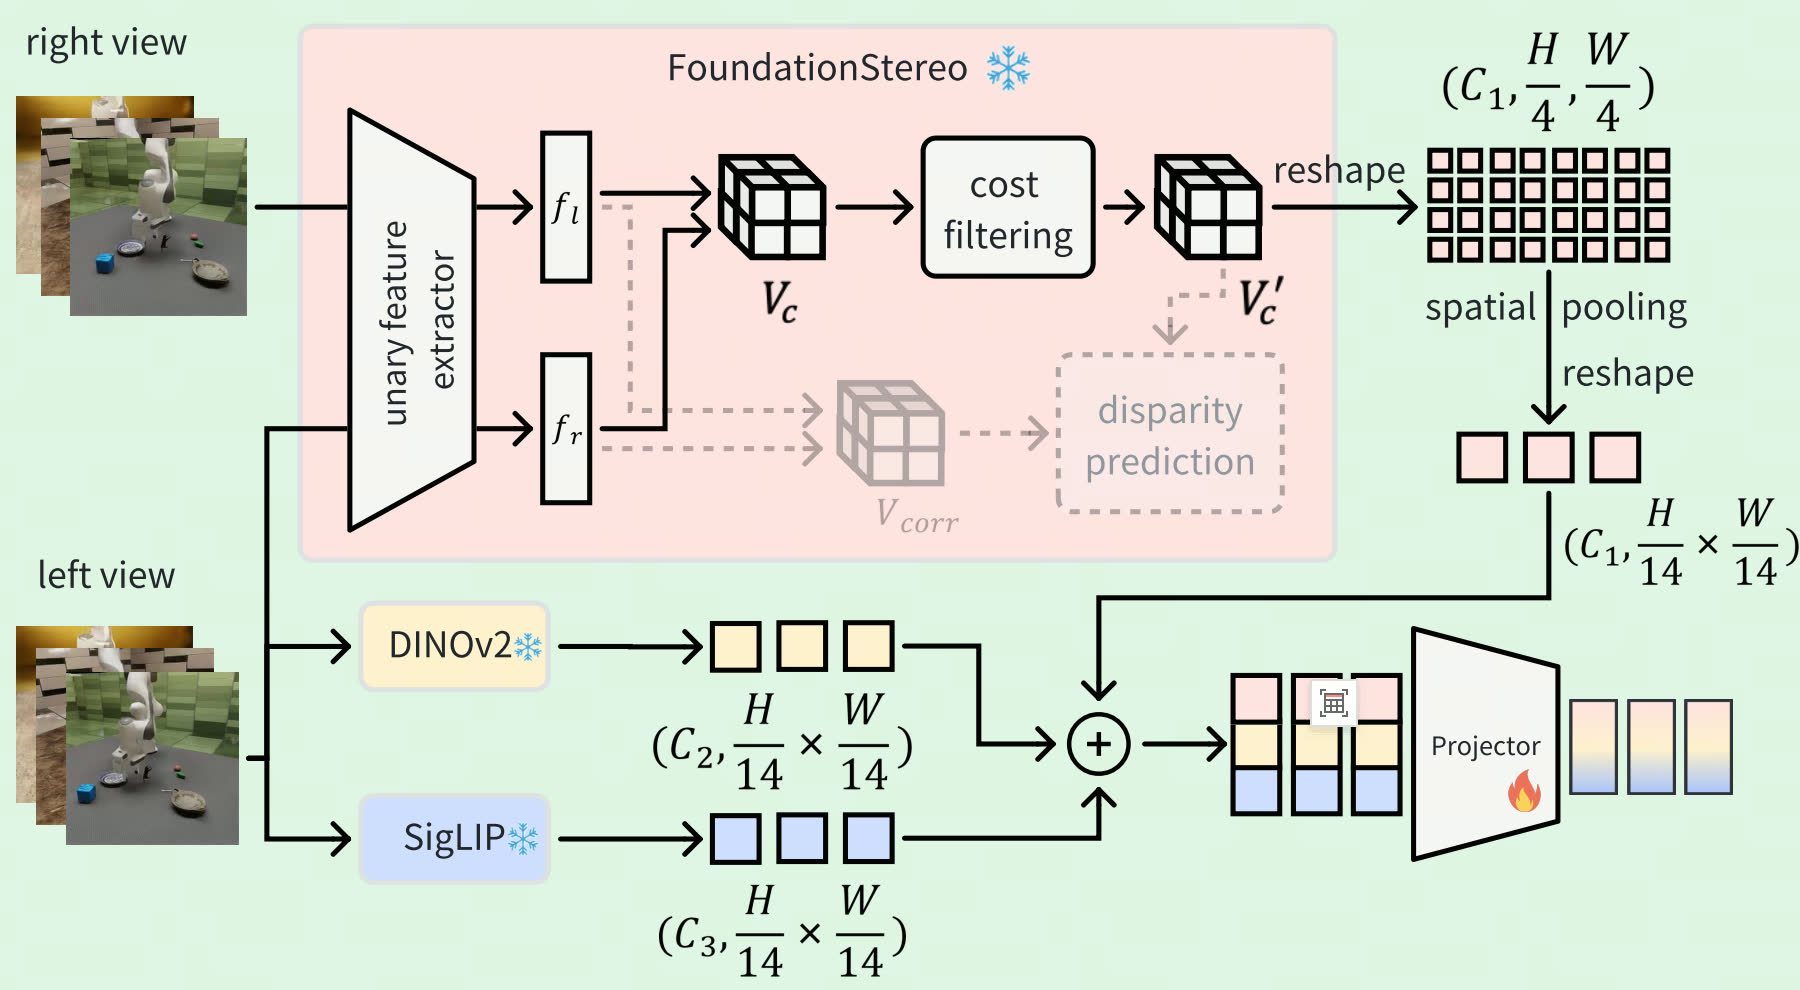
StereoVLA: Enhancing Vision-Language-Action Models with
Stereo Vision
Shengliang Deng*, Mi Yan*, Yixin Zheng*, Jiayi Su, Wenhao
Zhang, Xiaoguang Zhao, Heming Cui, Zhizheng
Zhang†,
He Wang†
                @article{2025StereoVLA,
                  title={StereoVLA: Enhancing Vision-Language-Action Models with Stereo Vision},
                  author={ Deng, Shengliang  and  Yan, Mi  and  Zheng, Yixin  and  Su, Jiayi  and  Zhang, Wenhao  and  Zhao, Xiaoguang  and  Cui, Heming  and  Zhang, Zhizheng  and  Wang, He },
                  year={2025},
                }
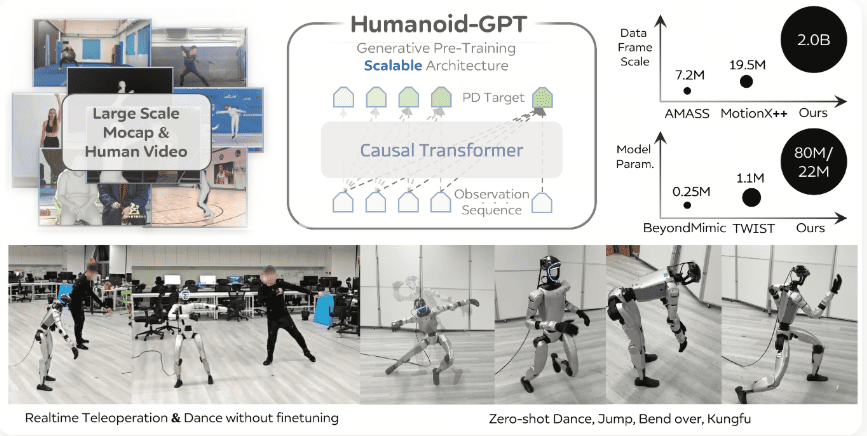
Humanoid Generative Pre-Training for Zero-Shot Motion
Tracking
                @article{humanoidgpt25,
                  title={Humanoid Generative Pre-Training for Zero-Shot Motion Tracking},
                  author={Qi, Zekun and Chen, Xuchuan and Wang, Jilong and Lin, Chenghuai and Lian, Yunrui and Zhang, Zhikai and Zhang, Wenyao and Yu, Xinqiang and Wang, He and Yi, Li},
                  journal={arXiv preprint arXiv:25xx.xxxxx},
                  year={2025}
                }
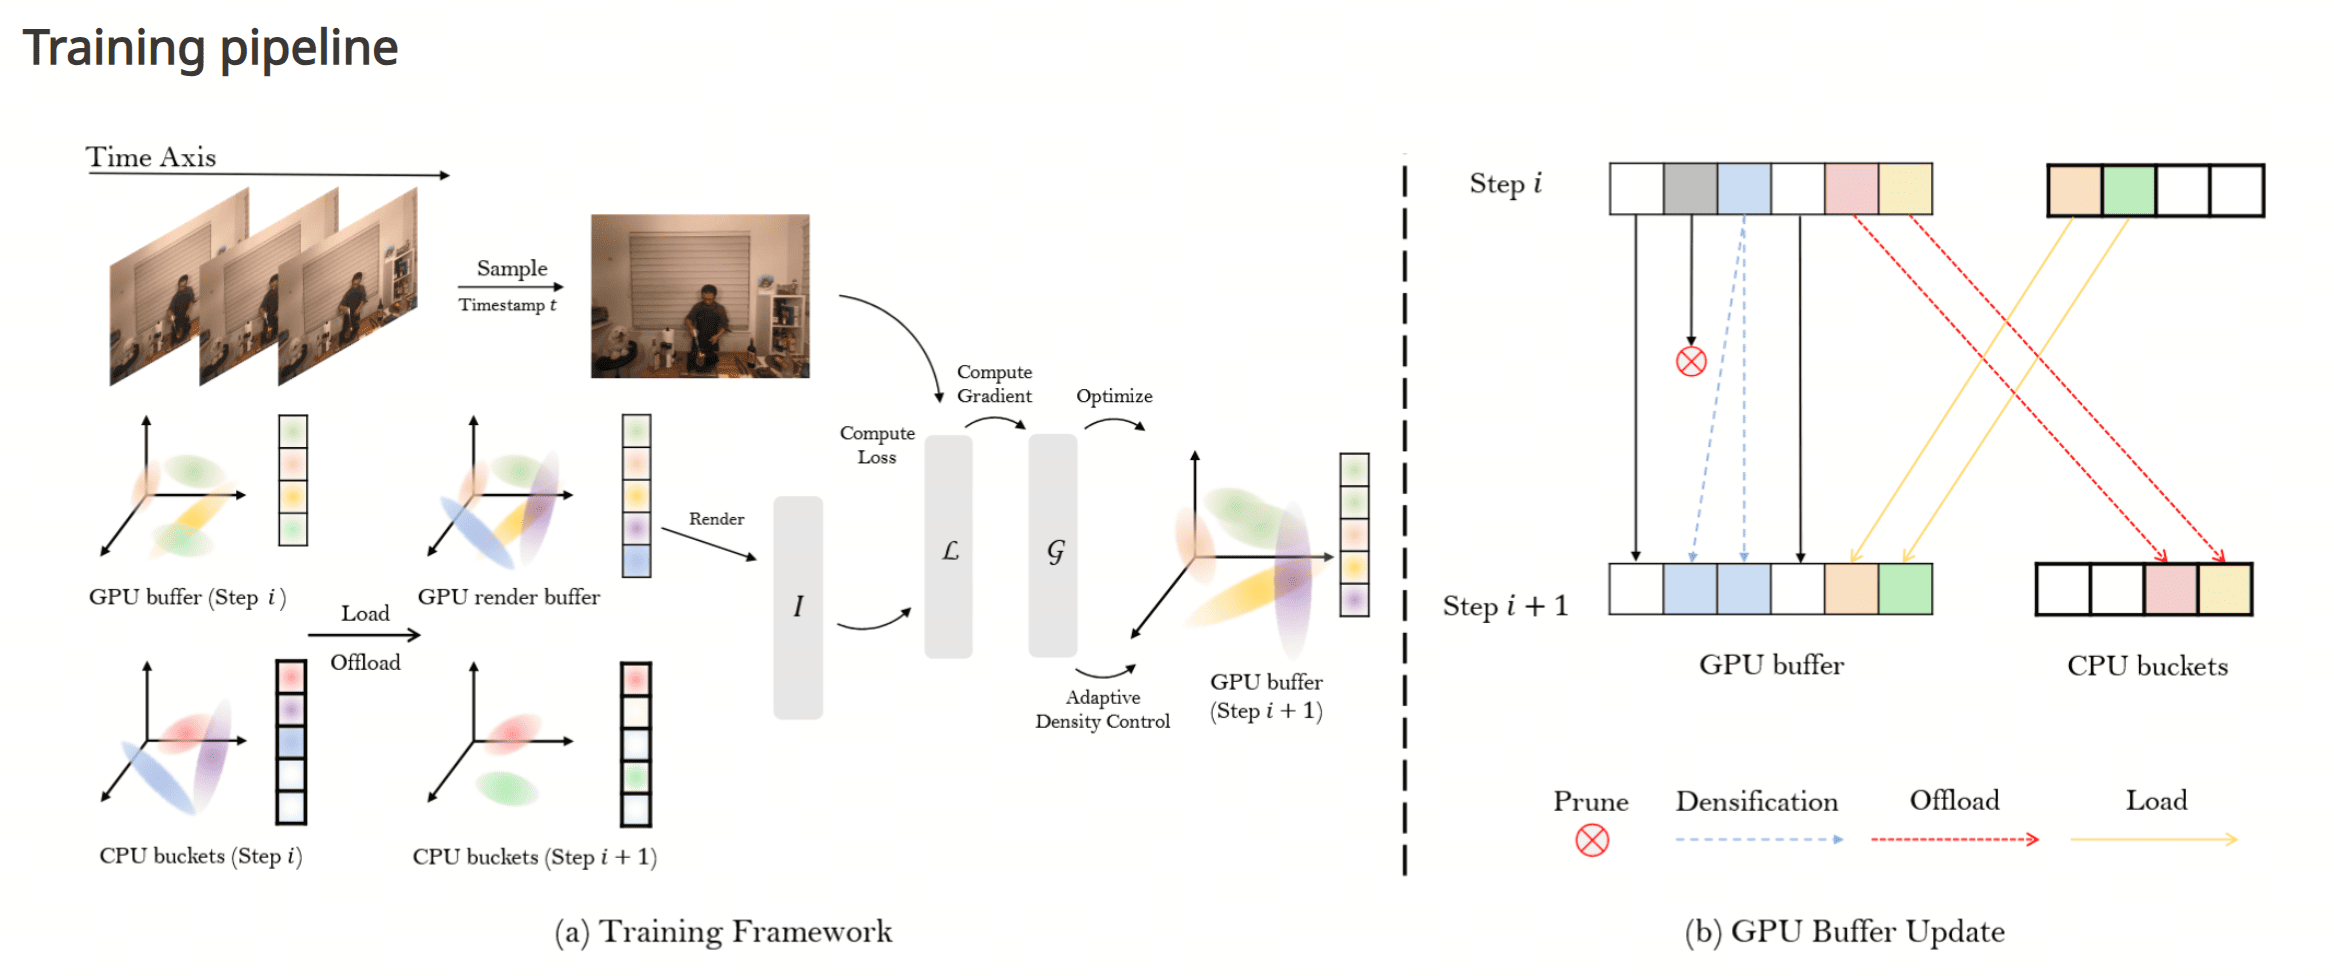
Layered 4D-Rotor Gaussian Splatting: A Compressed
Representation for Long Dynamic Scenes
Hanjie Xu*, Yuanxing Duan*, Qiyu Dai*, Ge Li†, Baoquan
Chen†,
He Wang†
                @misc{xu2025layered4drotor,
                  title  = {Layered {4D}-Rotor Gaussian Splatting: A Compressed Representation for Long Dynamic Scenes},
                  author = {Xu, Hanjie and Duan, Yuanxing and Dai, Qiyu and Li, Ge and Chen, Baoquan and Wang, He},
                  year   = {2026},
                  note   = {Manuscript in preparation; arXiv link to be added},
                }
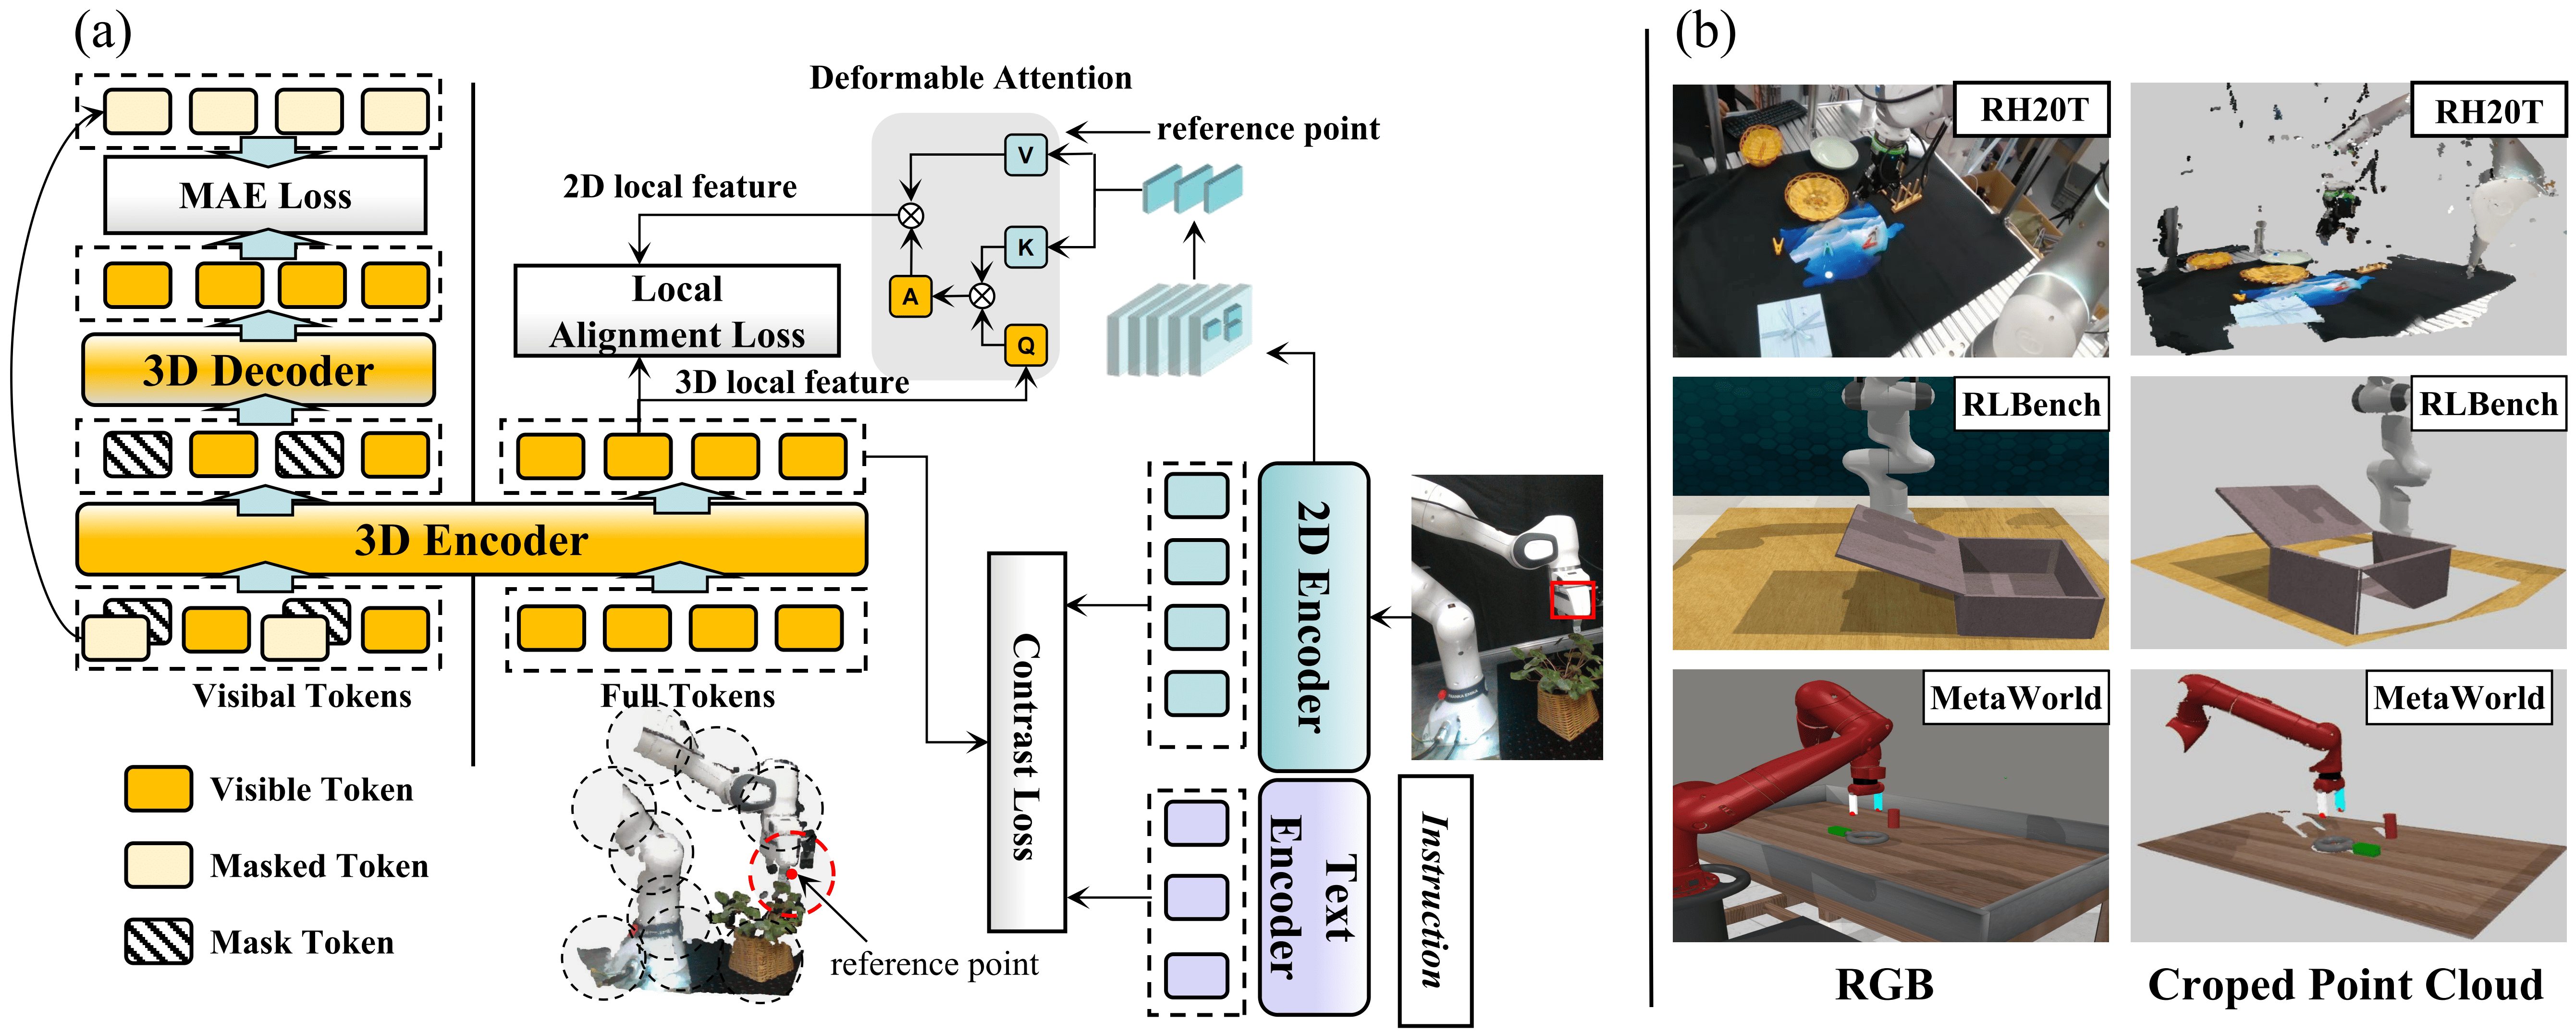
CL3R: 3D Reconstruction and Contrastive Learning for
Enhanced Robotic Manipulation Representations
                bibtex: @article{cui2025cl3r,
                  title={CL3R: 3D reconstruction and contrastive learning for enhanced robotic manipulation representations},
                  author={Cui, Wenbo and Zhao, Chengyang and Chen, Yuhui and Li, Haoran and Zhang, Zhizheng and Zhao, Dongbin and Wang, He},
                  journal={arXiv preprint arXiv:2507.08262},
                  year={2025}
                }
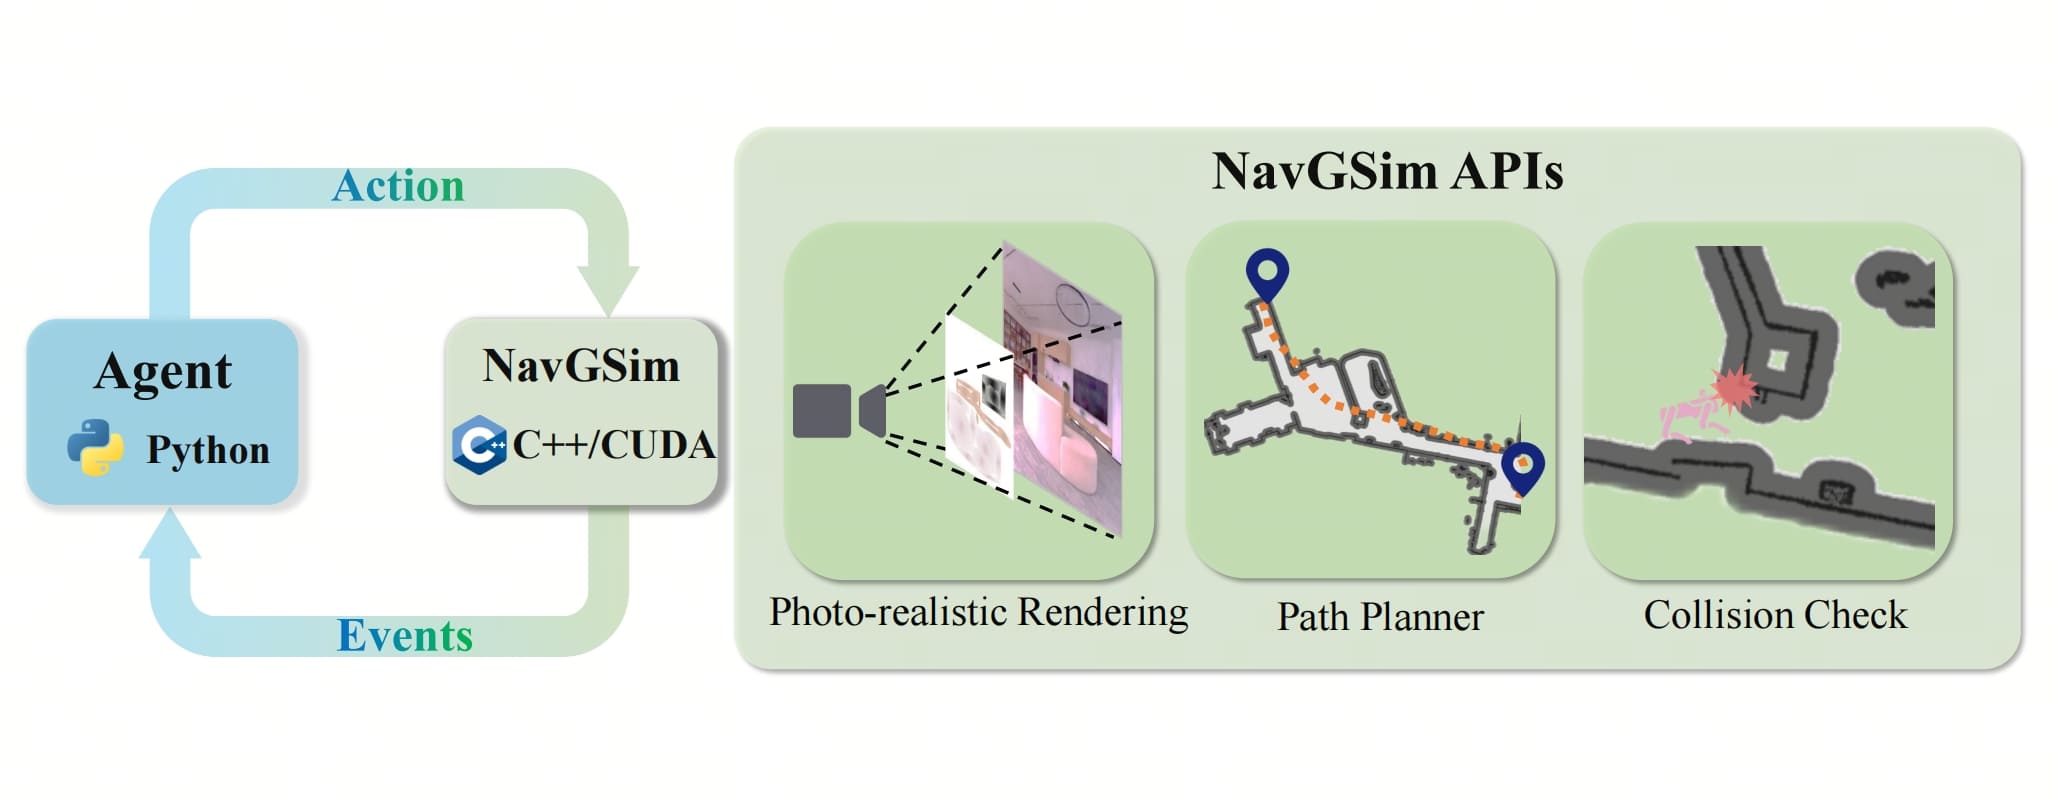
NavGSim: High-Fidelity Gaussian Splatting Simulator for
Large-Scale Navigation
                @misc{liu2026navgsimhighfidelitygaussiansplatting,
                    title={NavGSim: High-Fidelity Gaussian Splatting Simulator for Large-Scale Navigation},
                    author={Jiahang Liu and Yuanxing Duan and Jiazhao Zhang and Minghan Li and Shaoan Wang and Zhizheng Zhang and He Wang},
                    year={2026},
                    eprint={2603.15186},
                    archivePrefix={arXiv},
                    primaryClass={cs.RO},
                    url={https://arxiv.org/abs/2603.15186},
                }
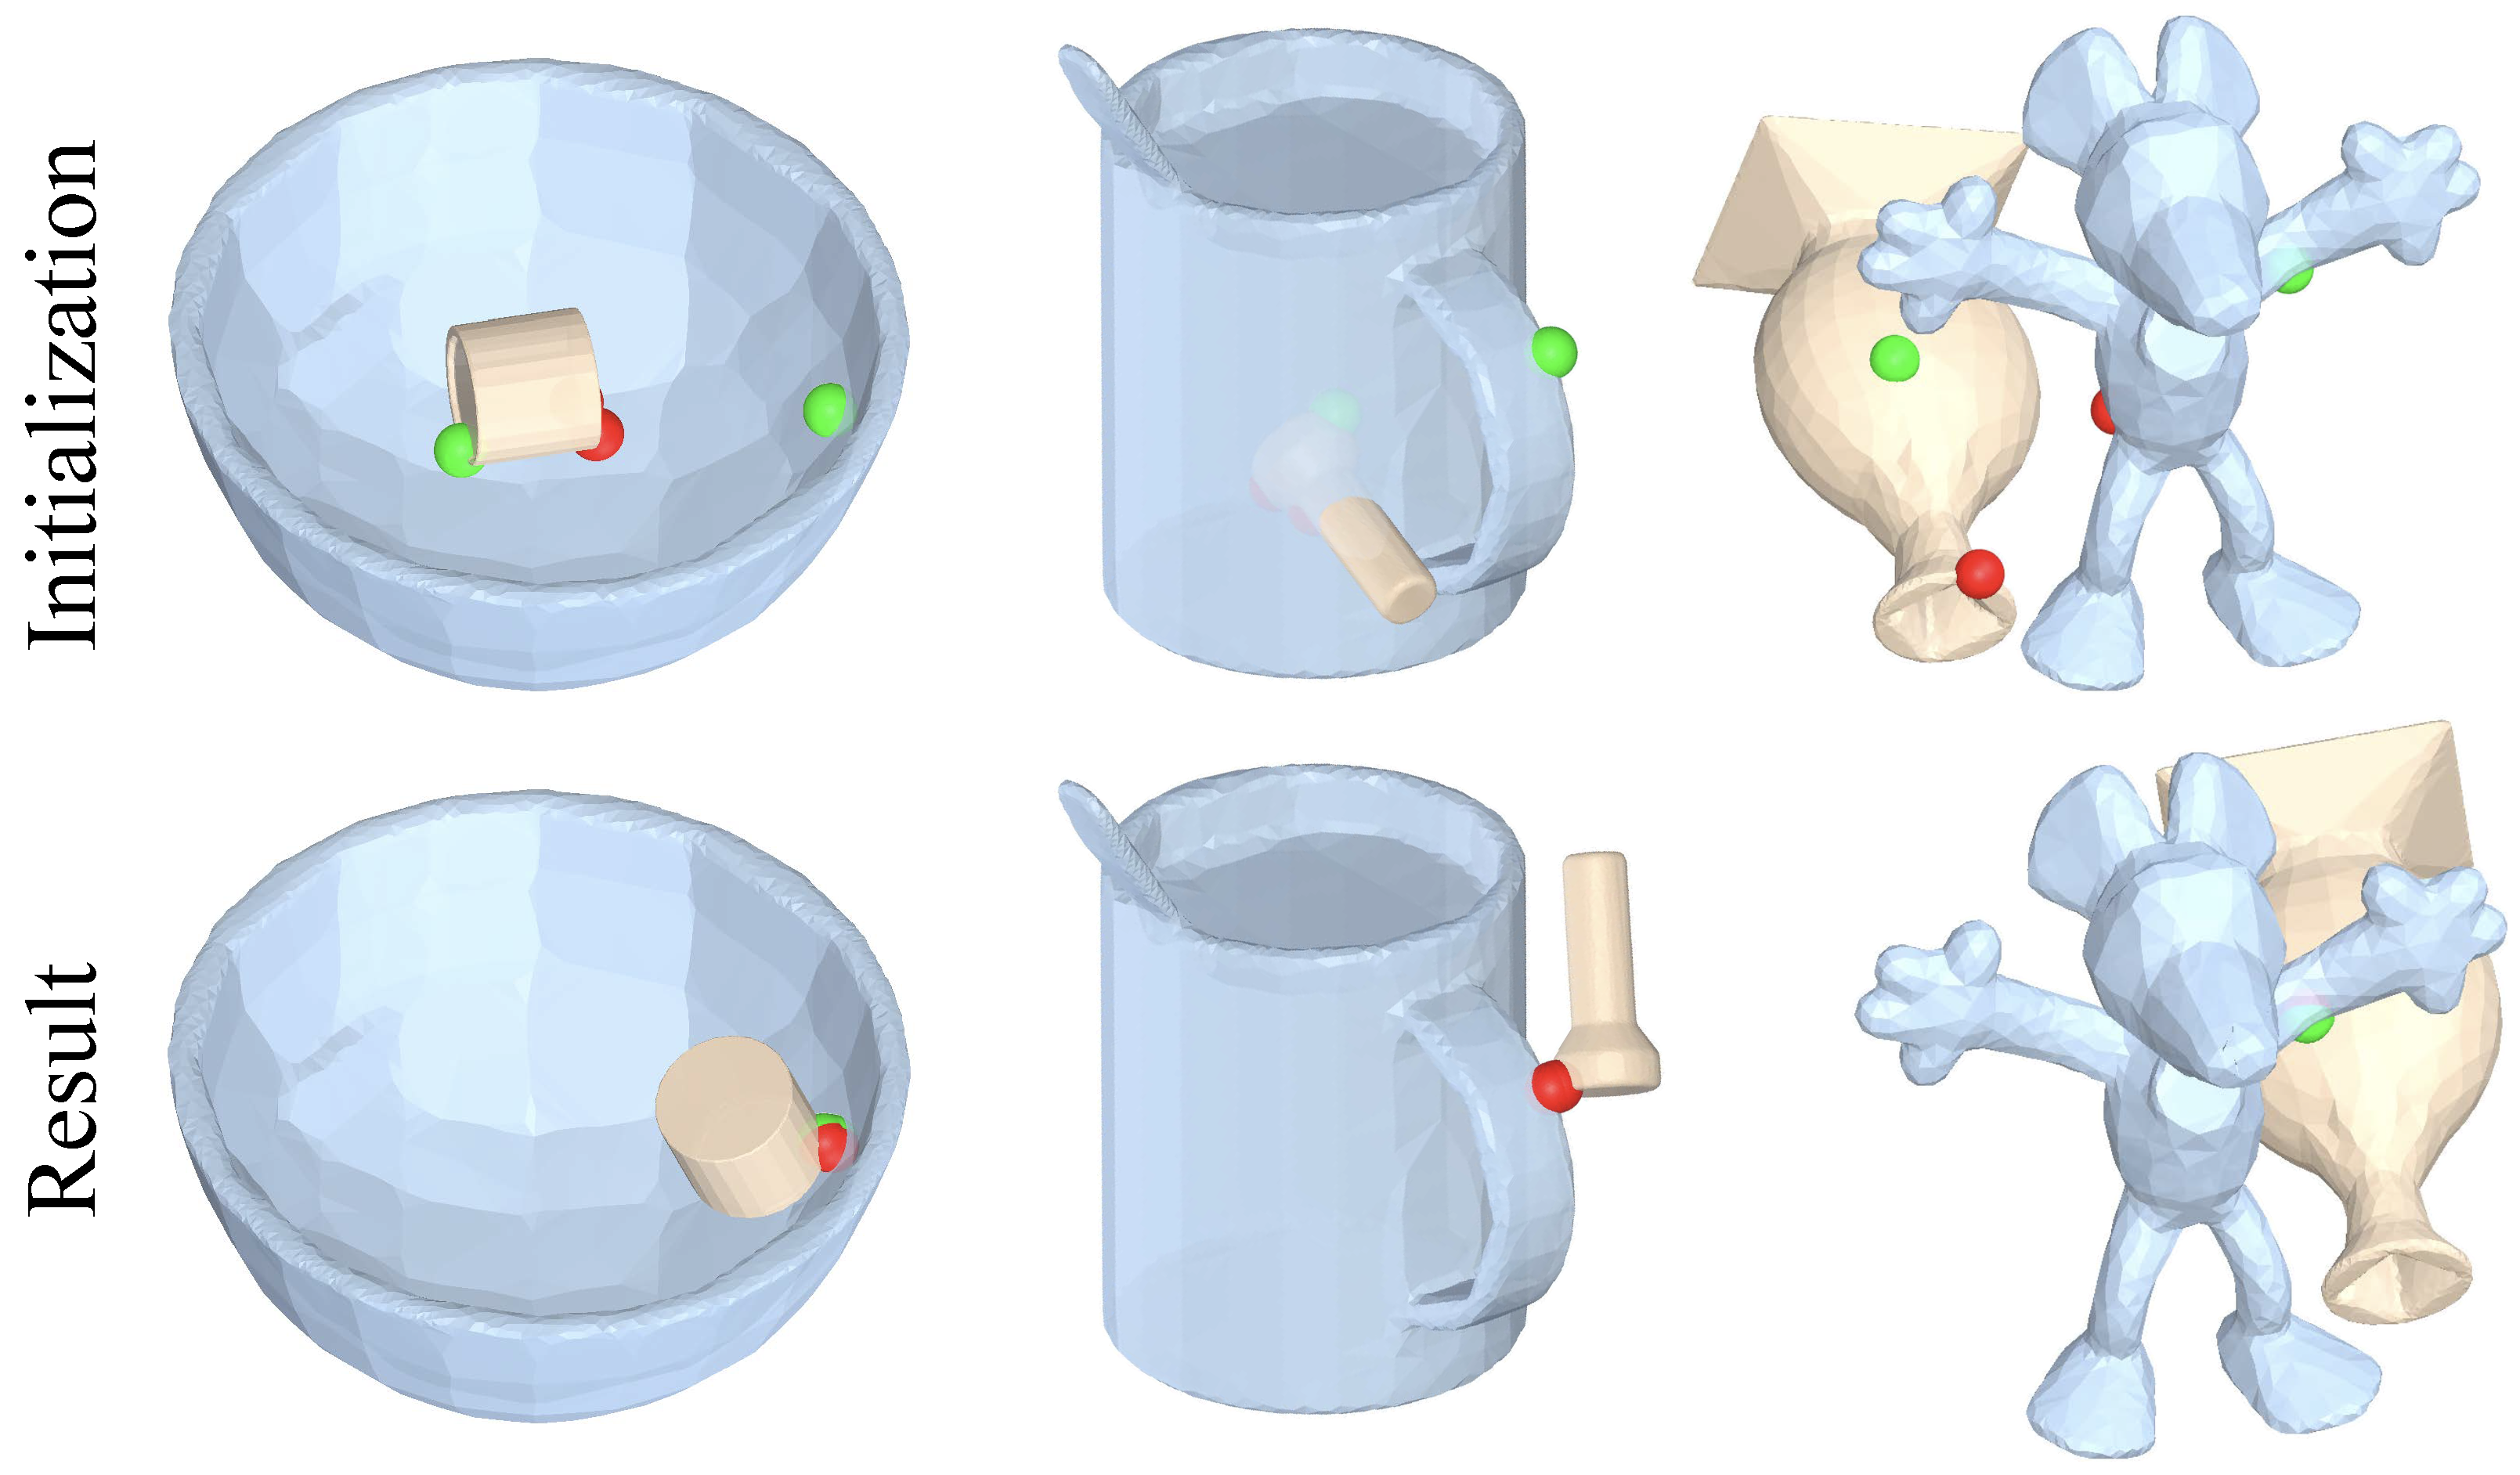
Robust Differentiable Collision Detection for General
Objects
Jiayi Chen, Wei Zhao, Liangwang Ruan, Baoquan Chen,
He Wang†
                @article{chen2025robust,
                  title={Robust Differentiable Collision Detection for General Objects},
                  author={Chen, Jiayi and Zhao, Wei and Ruan, Liangwang and Chen, Baoquan and Wang, He},
                  journal={arXiv preprint arXiv:2511.06267},
                  year={2025}
                }
UrbanVLA: A Vision-Language-Action Model for Urban
Micromobility
            @article{li2025urbanvla,
              title={UrbanVLA: A Vision-Language-Action Model for Urban Micromobility},
              author={Li, Anqi and Wang, Zhiyong and Zhang, Jiazhao and Li, Minghan and Qi, Yunpeng and Chen, Zhibo and Zhang, Zhizheng and Wang, He},
              journal={arXiv preprint arXiv:2510.23576},
              year={2025}
            }
TrackVLA++: Unleashing Reasoning and Memory Capabilities in
VLA Models for Embodied Visual Tracking
Jiahang Liu*, Yunpeng Qi*, Jiazhao Zhang*, Minghan Li,
Shaoan Wang, Kui Wu, Hanjing Ye, Hong Zhang, Zhibo Chen,
Fangwei Zhong, Zhizheng Zhang†,
He Wang†
            @article{2025TrackVLA,
              title={TrackVLA++: Unleashing Reasoning and Memory Capabilities in VLA Models for Embodied Visual Tracking},
              author={ Liu, Jiahang  and  Qi, Yunpeng  and  Zhang, Jiazhao  and  Li, Minghan  and  Wang, Shaoan  and
              Wu, Kui  and  Ye, Hanjing  and  Zhang, Hong  and  Chen, Zhibo  and  Zhong, Fangwei },
              year={2025},
            }
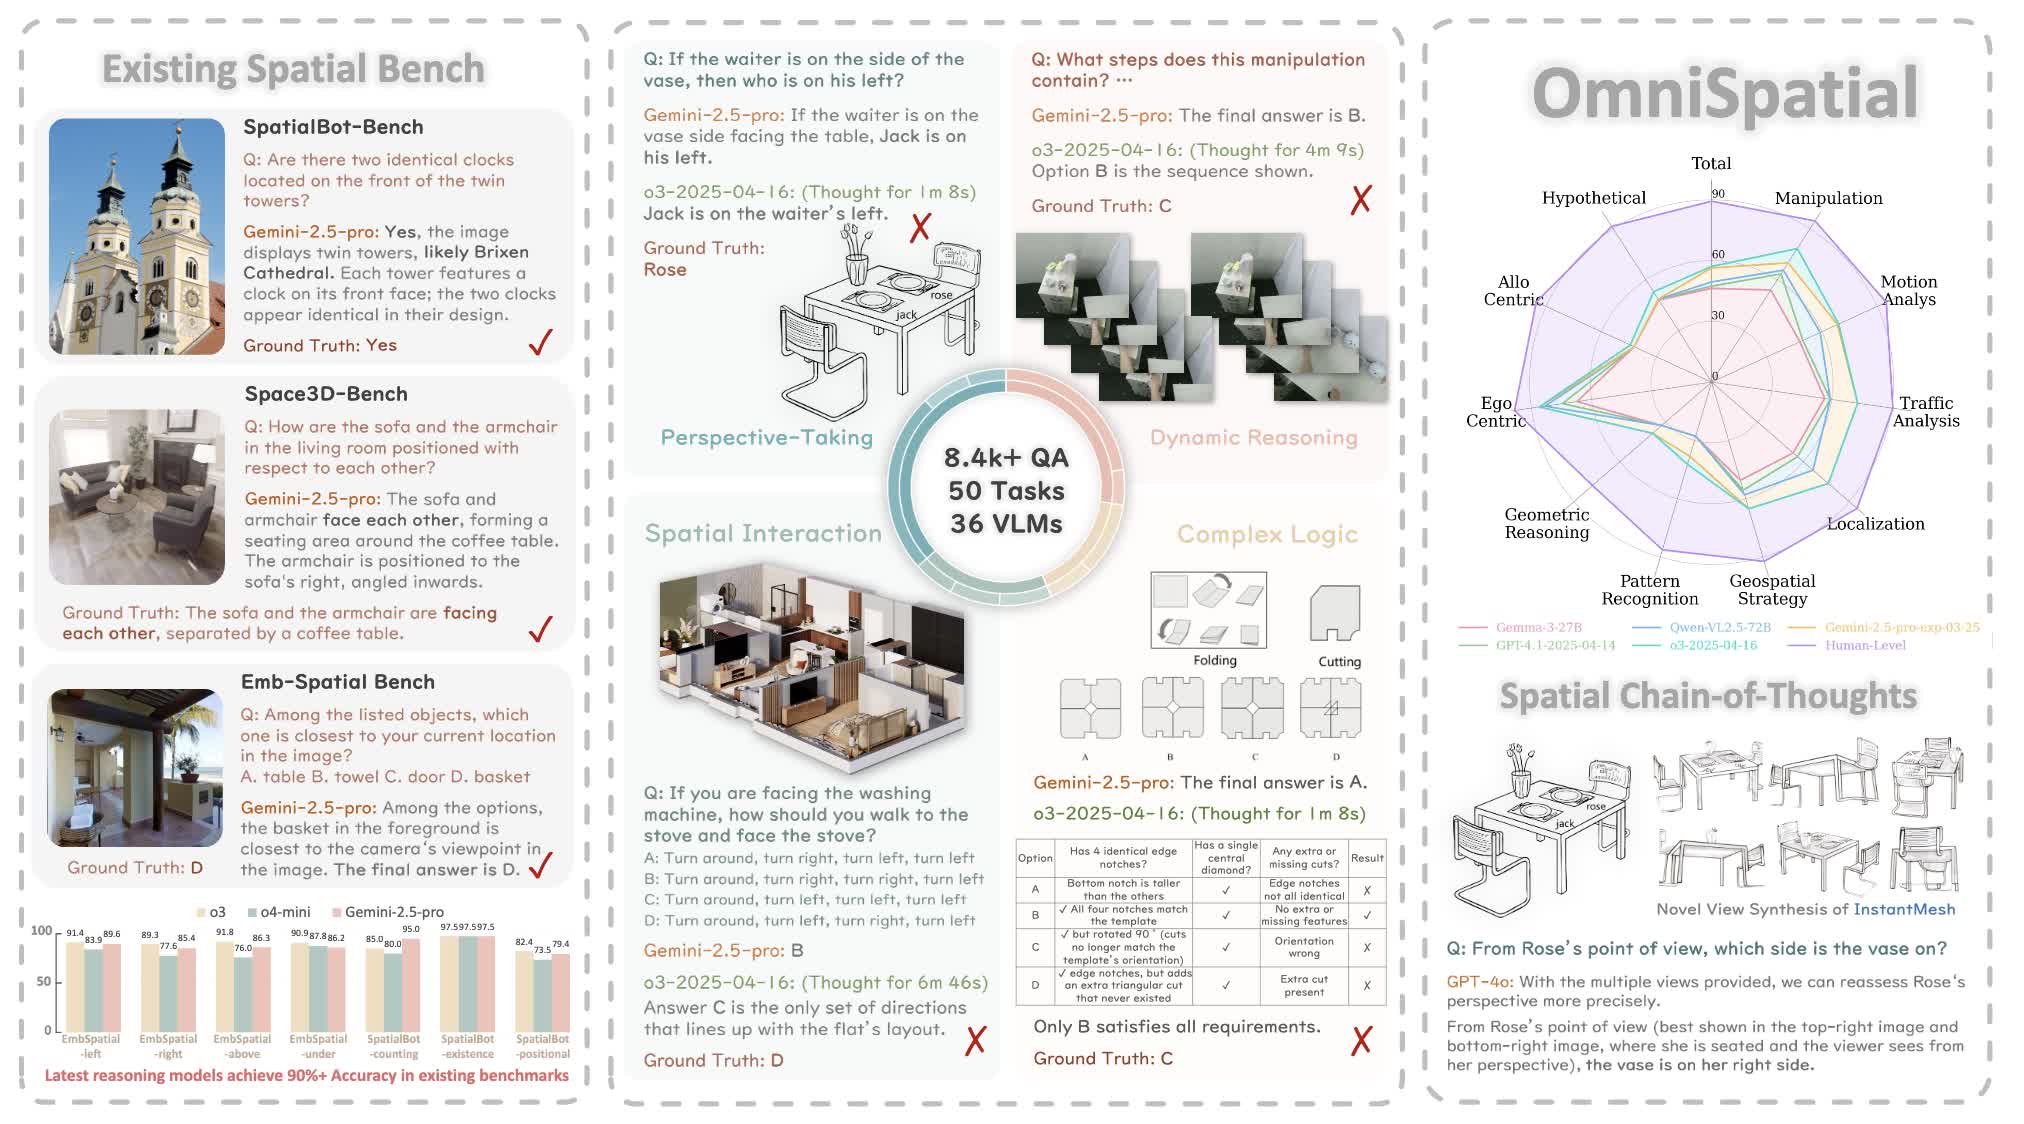
OmniSpatial: Towards Comprehensive Spatial Reasoning
Benchmark for Vision Language Models
Mengdi Jia*, Zekun Qi*, Shaochen Zhang, Wenyao Zhang,
Xinqiang Yu, Jiawei He, He Wang†, Li Yi†
            @article{omnispatial25,
              title={OmniSpatial: Towards Comprehensive Spatial Reasoning Benchmark for Vision Language Models},
              author={Jia, Mengdi and Qi, Zekun and Zhang, Shaochen and Zhang, Wenyao and Yu, Xinqiang and He, Jiawei and Wang, He and Yi, Li},
              journal={arXiv preprint arXiv:2506.03135},
              year={2025}
            }
            @article{zhang2025embodied,
              title={Embodied navigation foundation model},
              author={Zhang, Jiazhao and Li, Anqi and Qi, Yunpeng and Li, Minghan and Liu, Jiahang and
              Wang, Shaoan and Liu, Haoran and Zhou, Gengze and Wu, Yuze and Li, Xingxing and others},
              journal={arXiv preprint arXiv:2509.12129},
              year={2025}
            }
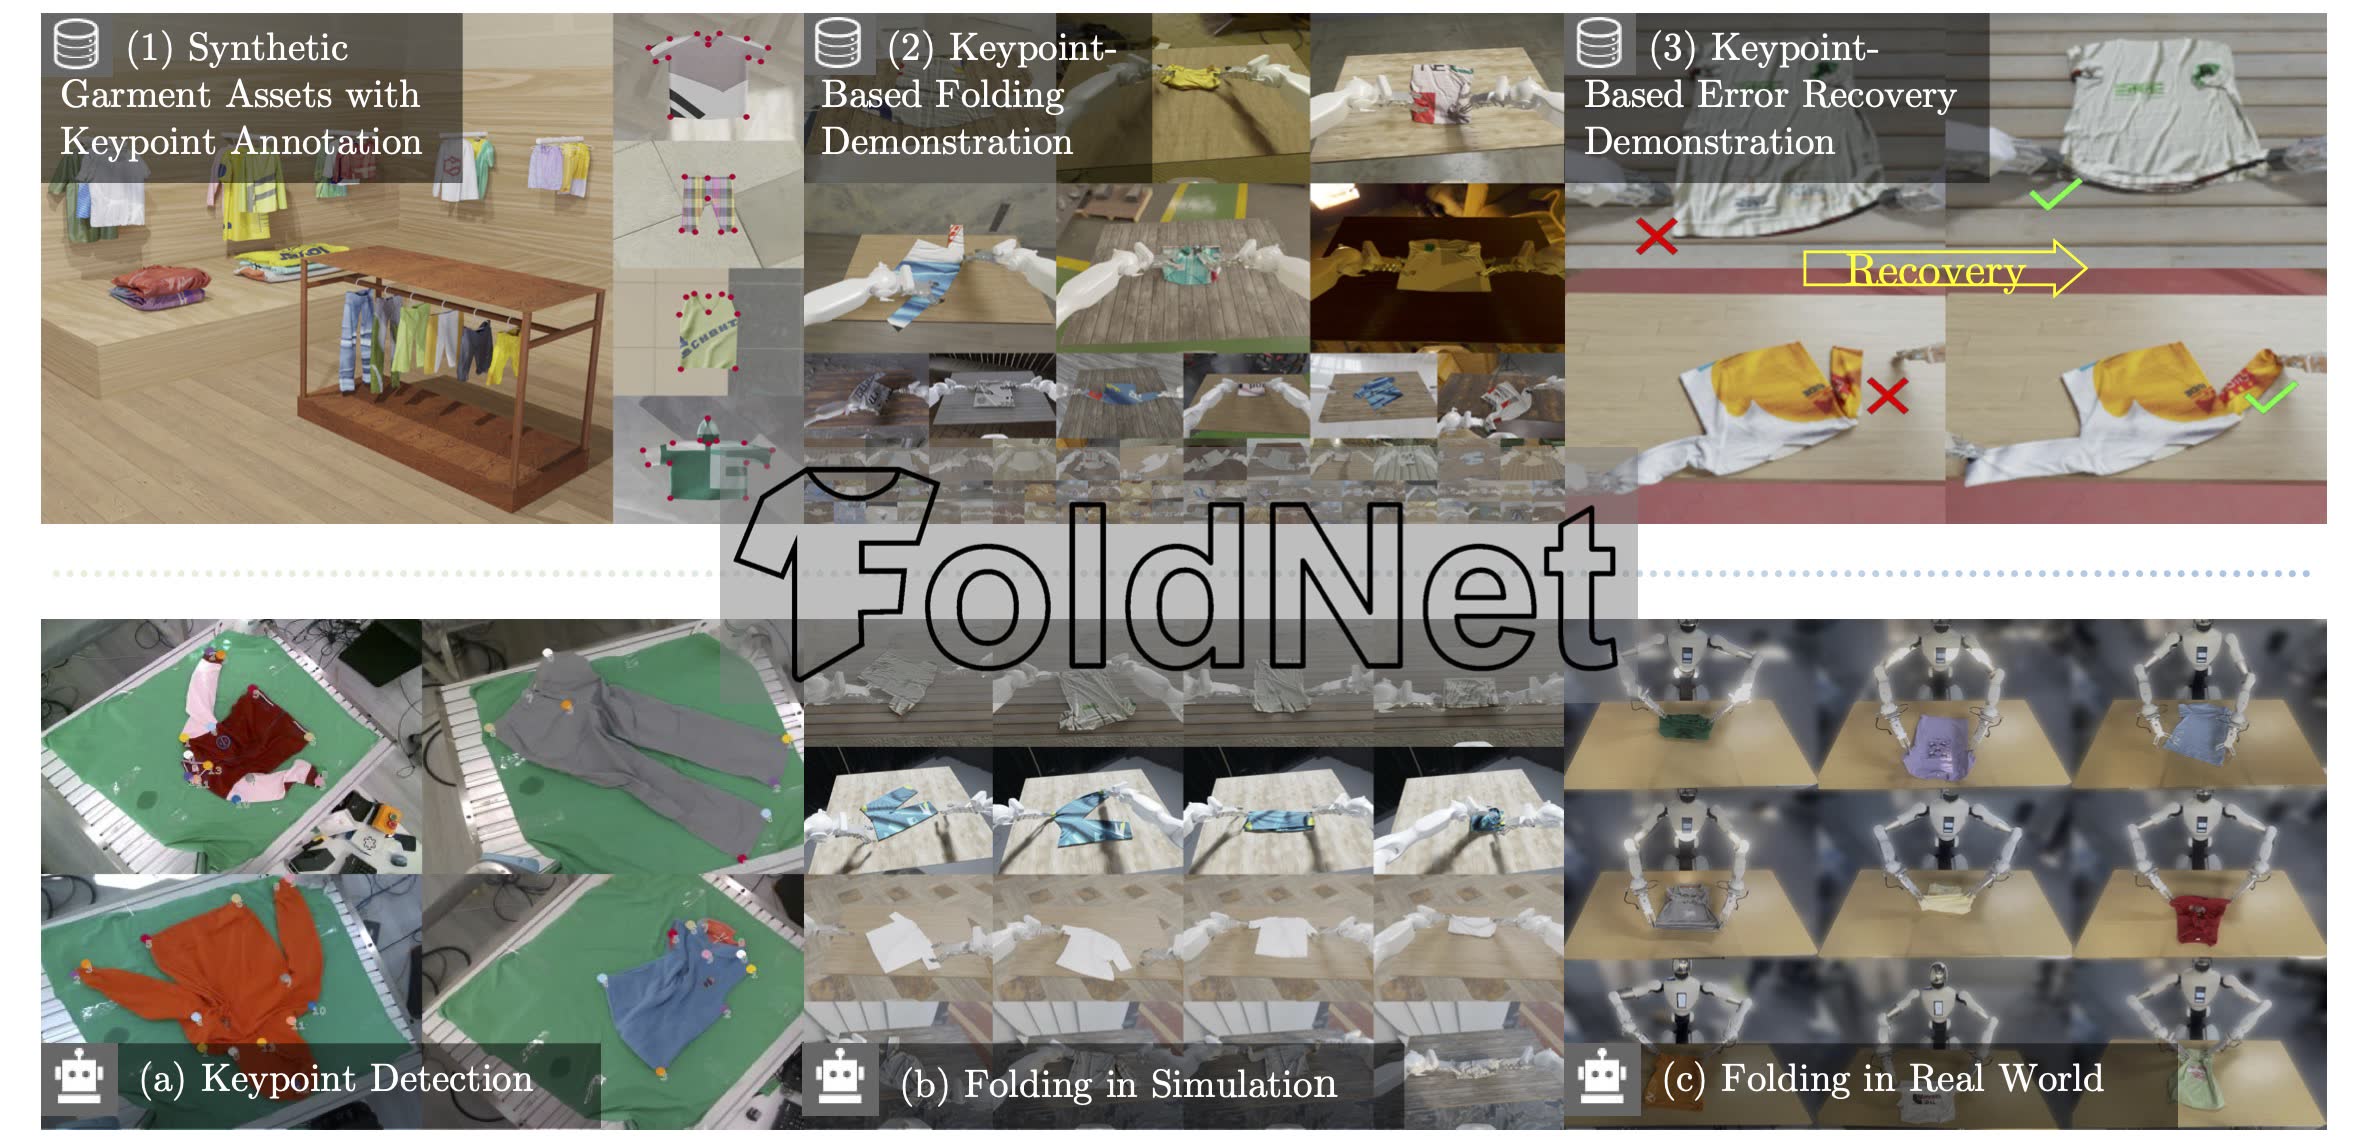
FoldNet: Learning Generalizable Closed-Loop Policy for
Garment Folding via Keypoint-Driven Asset and Demonstration
Synthesis
            bibtex: @article{sofar25,
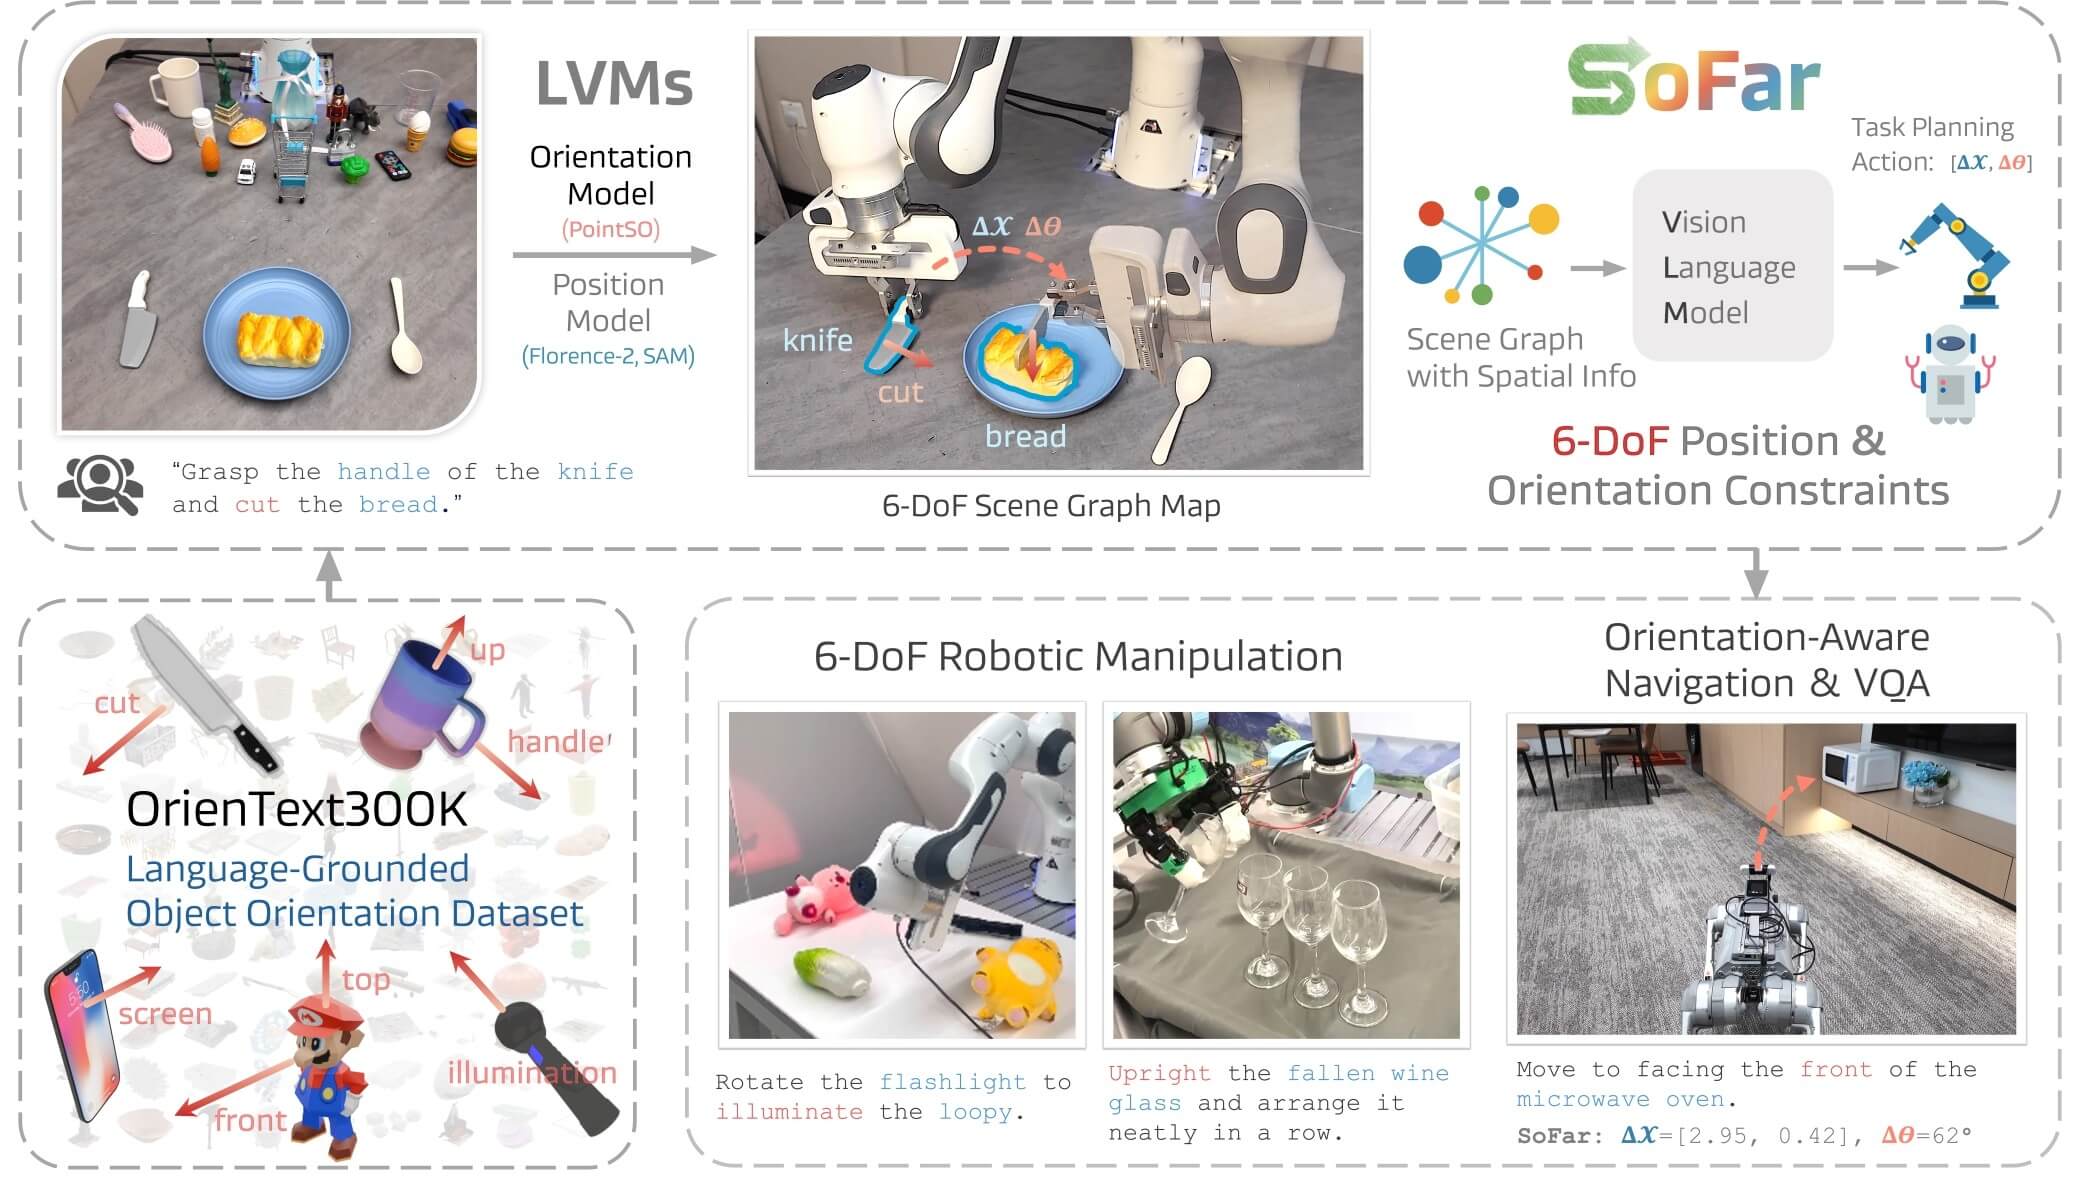
              title={Sofar: Language-grounded orientation bridges spatial reasoning and object manipulation},
              author={Qi, Zekun and Zhang, Wenyao and Ding, Yufei and Dong, Runpei and Yu, Xinqiang and Li, Jingwen and Xu, Lingyun and Li, Baoyu and He, Xialin and Fan, Guofan and others},
              journal={arXiv preprint arXiv:2502.13143},
              year={2025}
            }
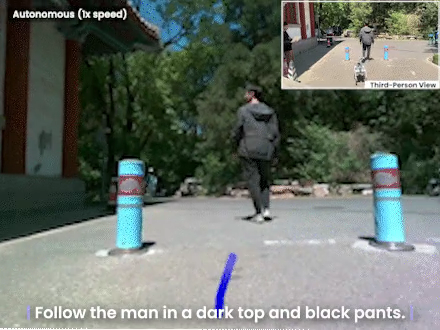
TrackVLA: Embodied Visual Tracking in the Wild
Shaoan Wang*, Jiazhao Zhang*, Minghan Li, Jiahang Liu, Anqi
Li, Kui Wu, Fangwei Zhong, Junzhi Yu, Zhizheng
Zhang†,
He Wang†
            @article{wang2025trackvla,
              author  = {Wang, Shaoan and Zhang, Jiazhao and Li, Minghan and Liu, Jiahang and Li, Anqi and Wu, Kui and Zhong, Fangwei and Yu, Junzhi and Zhang, Zhizheng and Wang, He},
              title   = {TrackVLA: Embodied Visual Tracking in the Wild},
              journal = {arXiv pre-print},
              year    = {2025},
              url     = {http://arxiv.org/abs/2505.23189}
          }
FetchBot: Learning Generalizable Object Fetching in
Cluttered Scenes via Zero-Shot Sim2Real
            @inproceedings{liufetchbot,
              title={FetchBot: Learning Generalizable Object Fetching in Cluttered Scenes via Zero-Shot Sim2Real},
              author={Liu, Weiheng and Wan, Yuxuan and Wang, Jilong and Kuang, Yuxuan and Shi, Xuesong and Li, Haoran and Zhao, Dongbin and Zhang, Zhizheng and Wang, He},
              booktitle={9th Annual Conference on Robot Learning}
            }
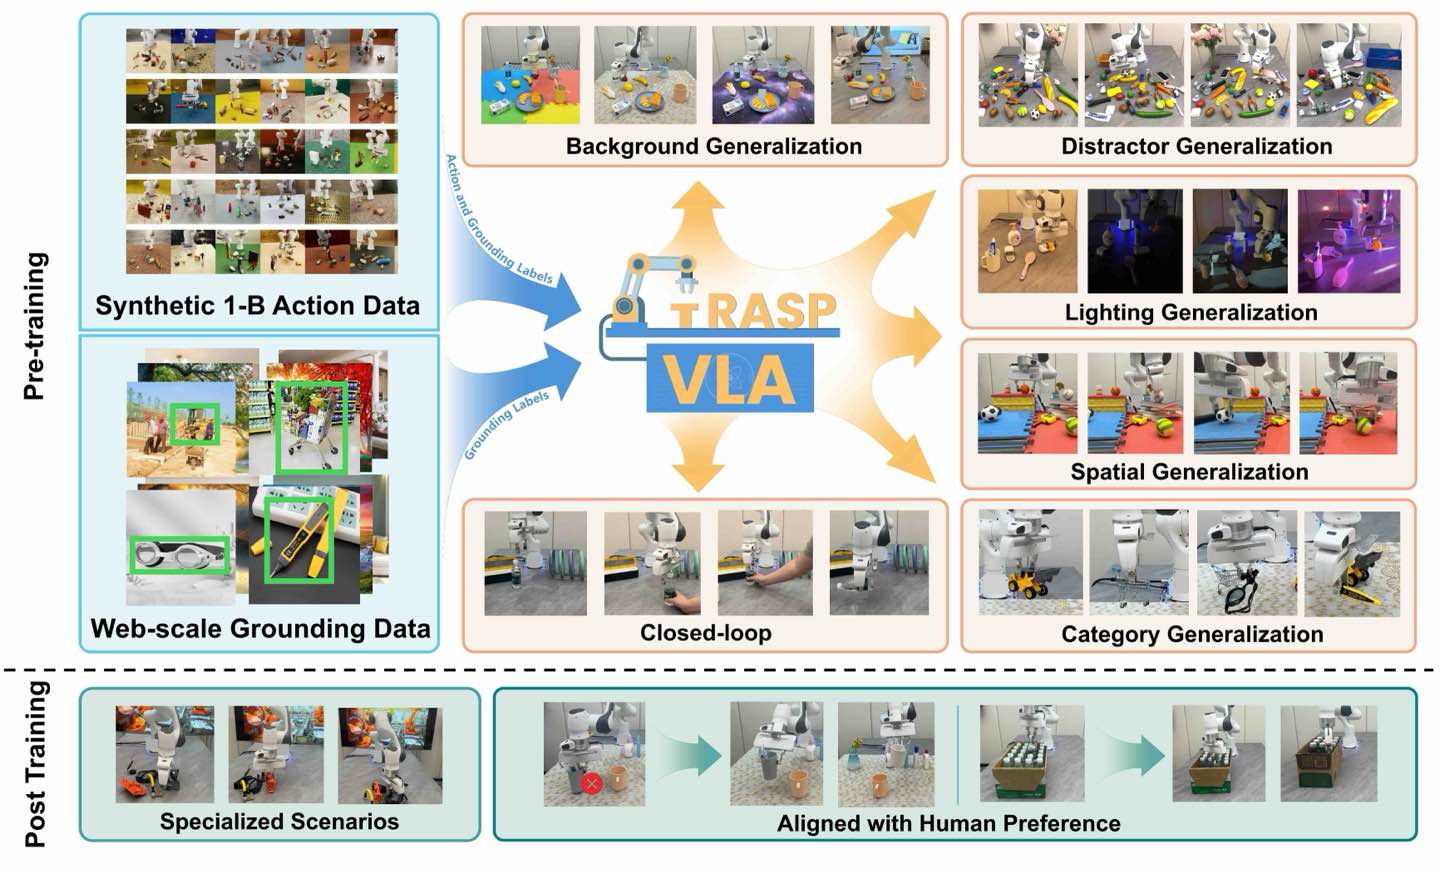
GraspVLA: a Grasping Foundation Model Pre-trained on
Billion-scale Synthetic Action Data
            @article{deng2025graspvla,
                title={GraspVLA: a Grasping Foundation Model Pre-trained on Billion-scale Synthetic Action Data},
                author={Shengliang Deng and Mi Yan and Songlin Wei and Haixin Ma and Yuxin Yang and Jiayi Chen and Zhiqi Zhang and Taoyu Yang and Xuheng Zhang and Wenhao Zhang and Heming Cui and Zhizheng Zhang and He Wang},
                year={2025},
                eprint={2505.03233},
                archivePrefix={arXiv},
                primaryClass={cs.RO},
                url={https://arxiv.org/abs/2505.03233}
            }
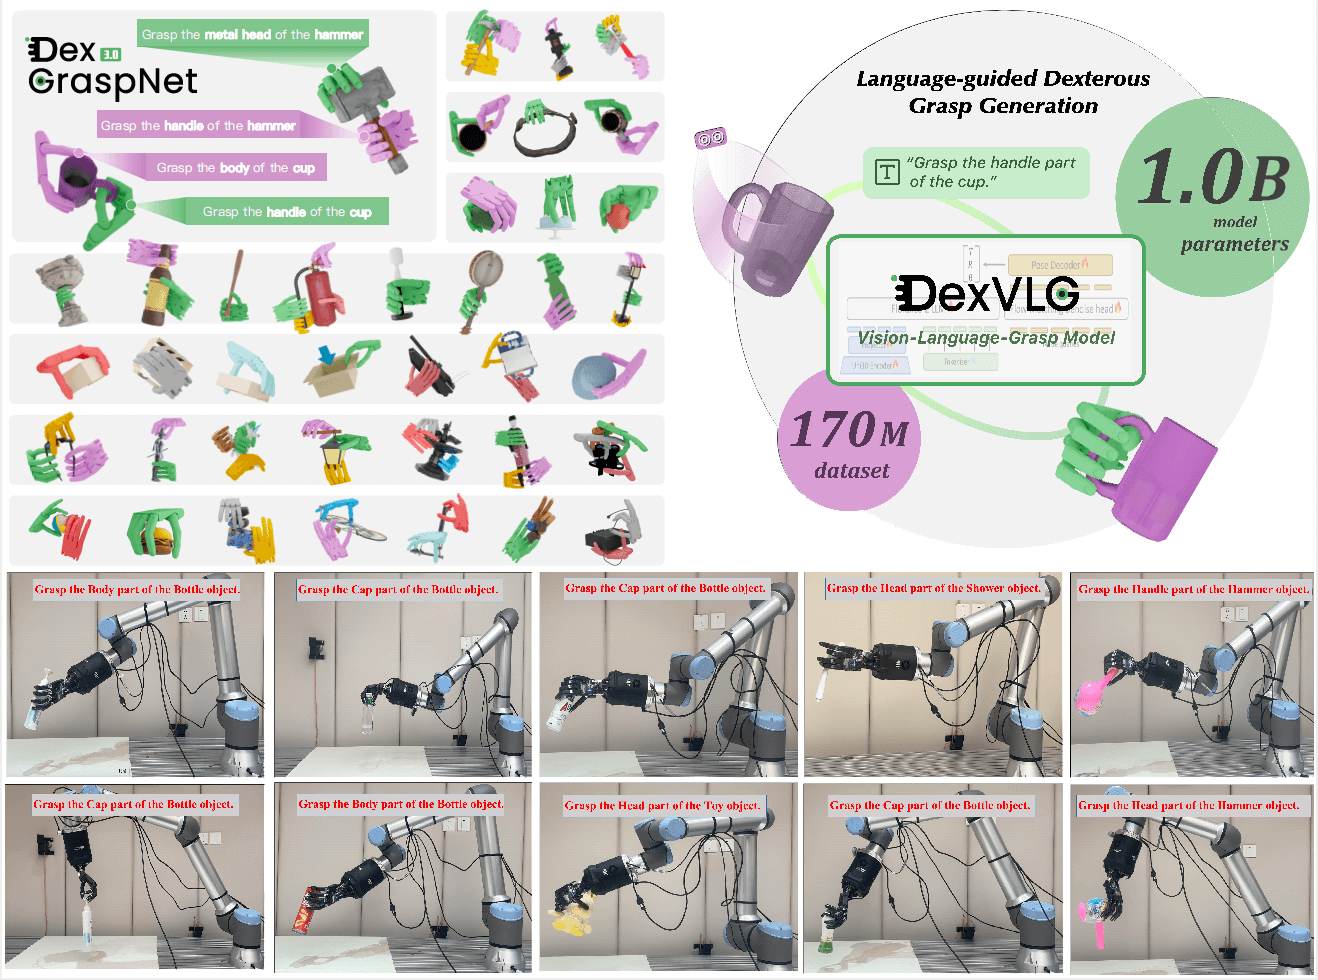
DexVLG: Dexterous Vision-Language-Grasp Model at Scale
Jiawei He*, Danshi Li*, Xinqiang Yu*, Zekun Qi, Wenyao
Zhang, Jiayi Chen, Zhaoxiang Zhang†,
Zhizheng Zhang†, Li
Yi†,
He Wang†
              @misc{he2025dexvlgdexterousvisionlanguagegraspmodel,
                title={DexVLG: Dexterous Vision-Language-Grasp Model at Scale},
                author={Jiawei He and Danshi Li and Xinqiang Yu and Zekun Qi and Wenyao Zhang and Jiayi Chen and Zhaoxiang Zhang and Zhizheng Zhang and Li Yi and He Wang},
                year={2025},
                eprint={2507.02747},
                archivePrefix={arXiv},
                primaryClass={cs.CV},
                url={https://arxiv.org/abs/2507.02747},
              }
DyWA: Dynamics-adaptive World Action Model for Generalizable
Non-prehensile Manipulation
              @article{lyu2025dywa,
                title={DyWA: Dynamics-adaptive World Action Model for Generalizable Non-prehensile Manipulation},
                author={Lyu, Jiangran and Li, Ziming and Shi, Xuesong and Xu, Chaoyi and Wang, Yizhou and Wang, He},
                journal={arXiv preprint arXiv:2503.16806},
                year={2025}
              }
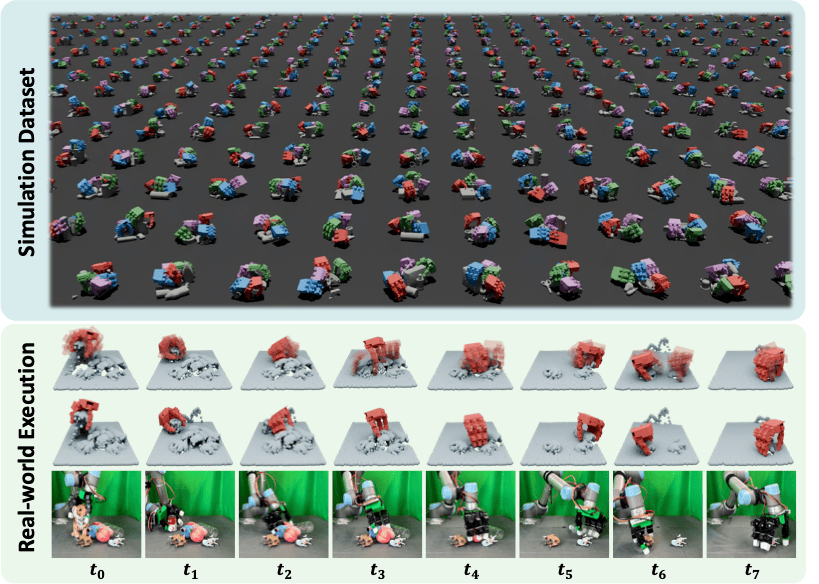
RoboHanger: Learning Generalizable Robotic Hanger Insertion
for Diverse Garments
              @misc{chen2025robohangerlearninggeneralizablerobotic,
                title={RoboHanger: Learning Generalizable Robotic Hanger Insertion for Diverse Garments},
                author={Yuxing Chen and Songlin Wei and Bowen Xiao and Jiangran Lyu and Jiayi Chen and Feng Zhu and He Wang},
                year={2025},
                eprint={2412.01083},
                archivePrefix={arXiv},
                primaryClass={cs.RO},
                url={https://arxiv.org/abs/2412.01083},
              }
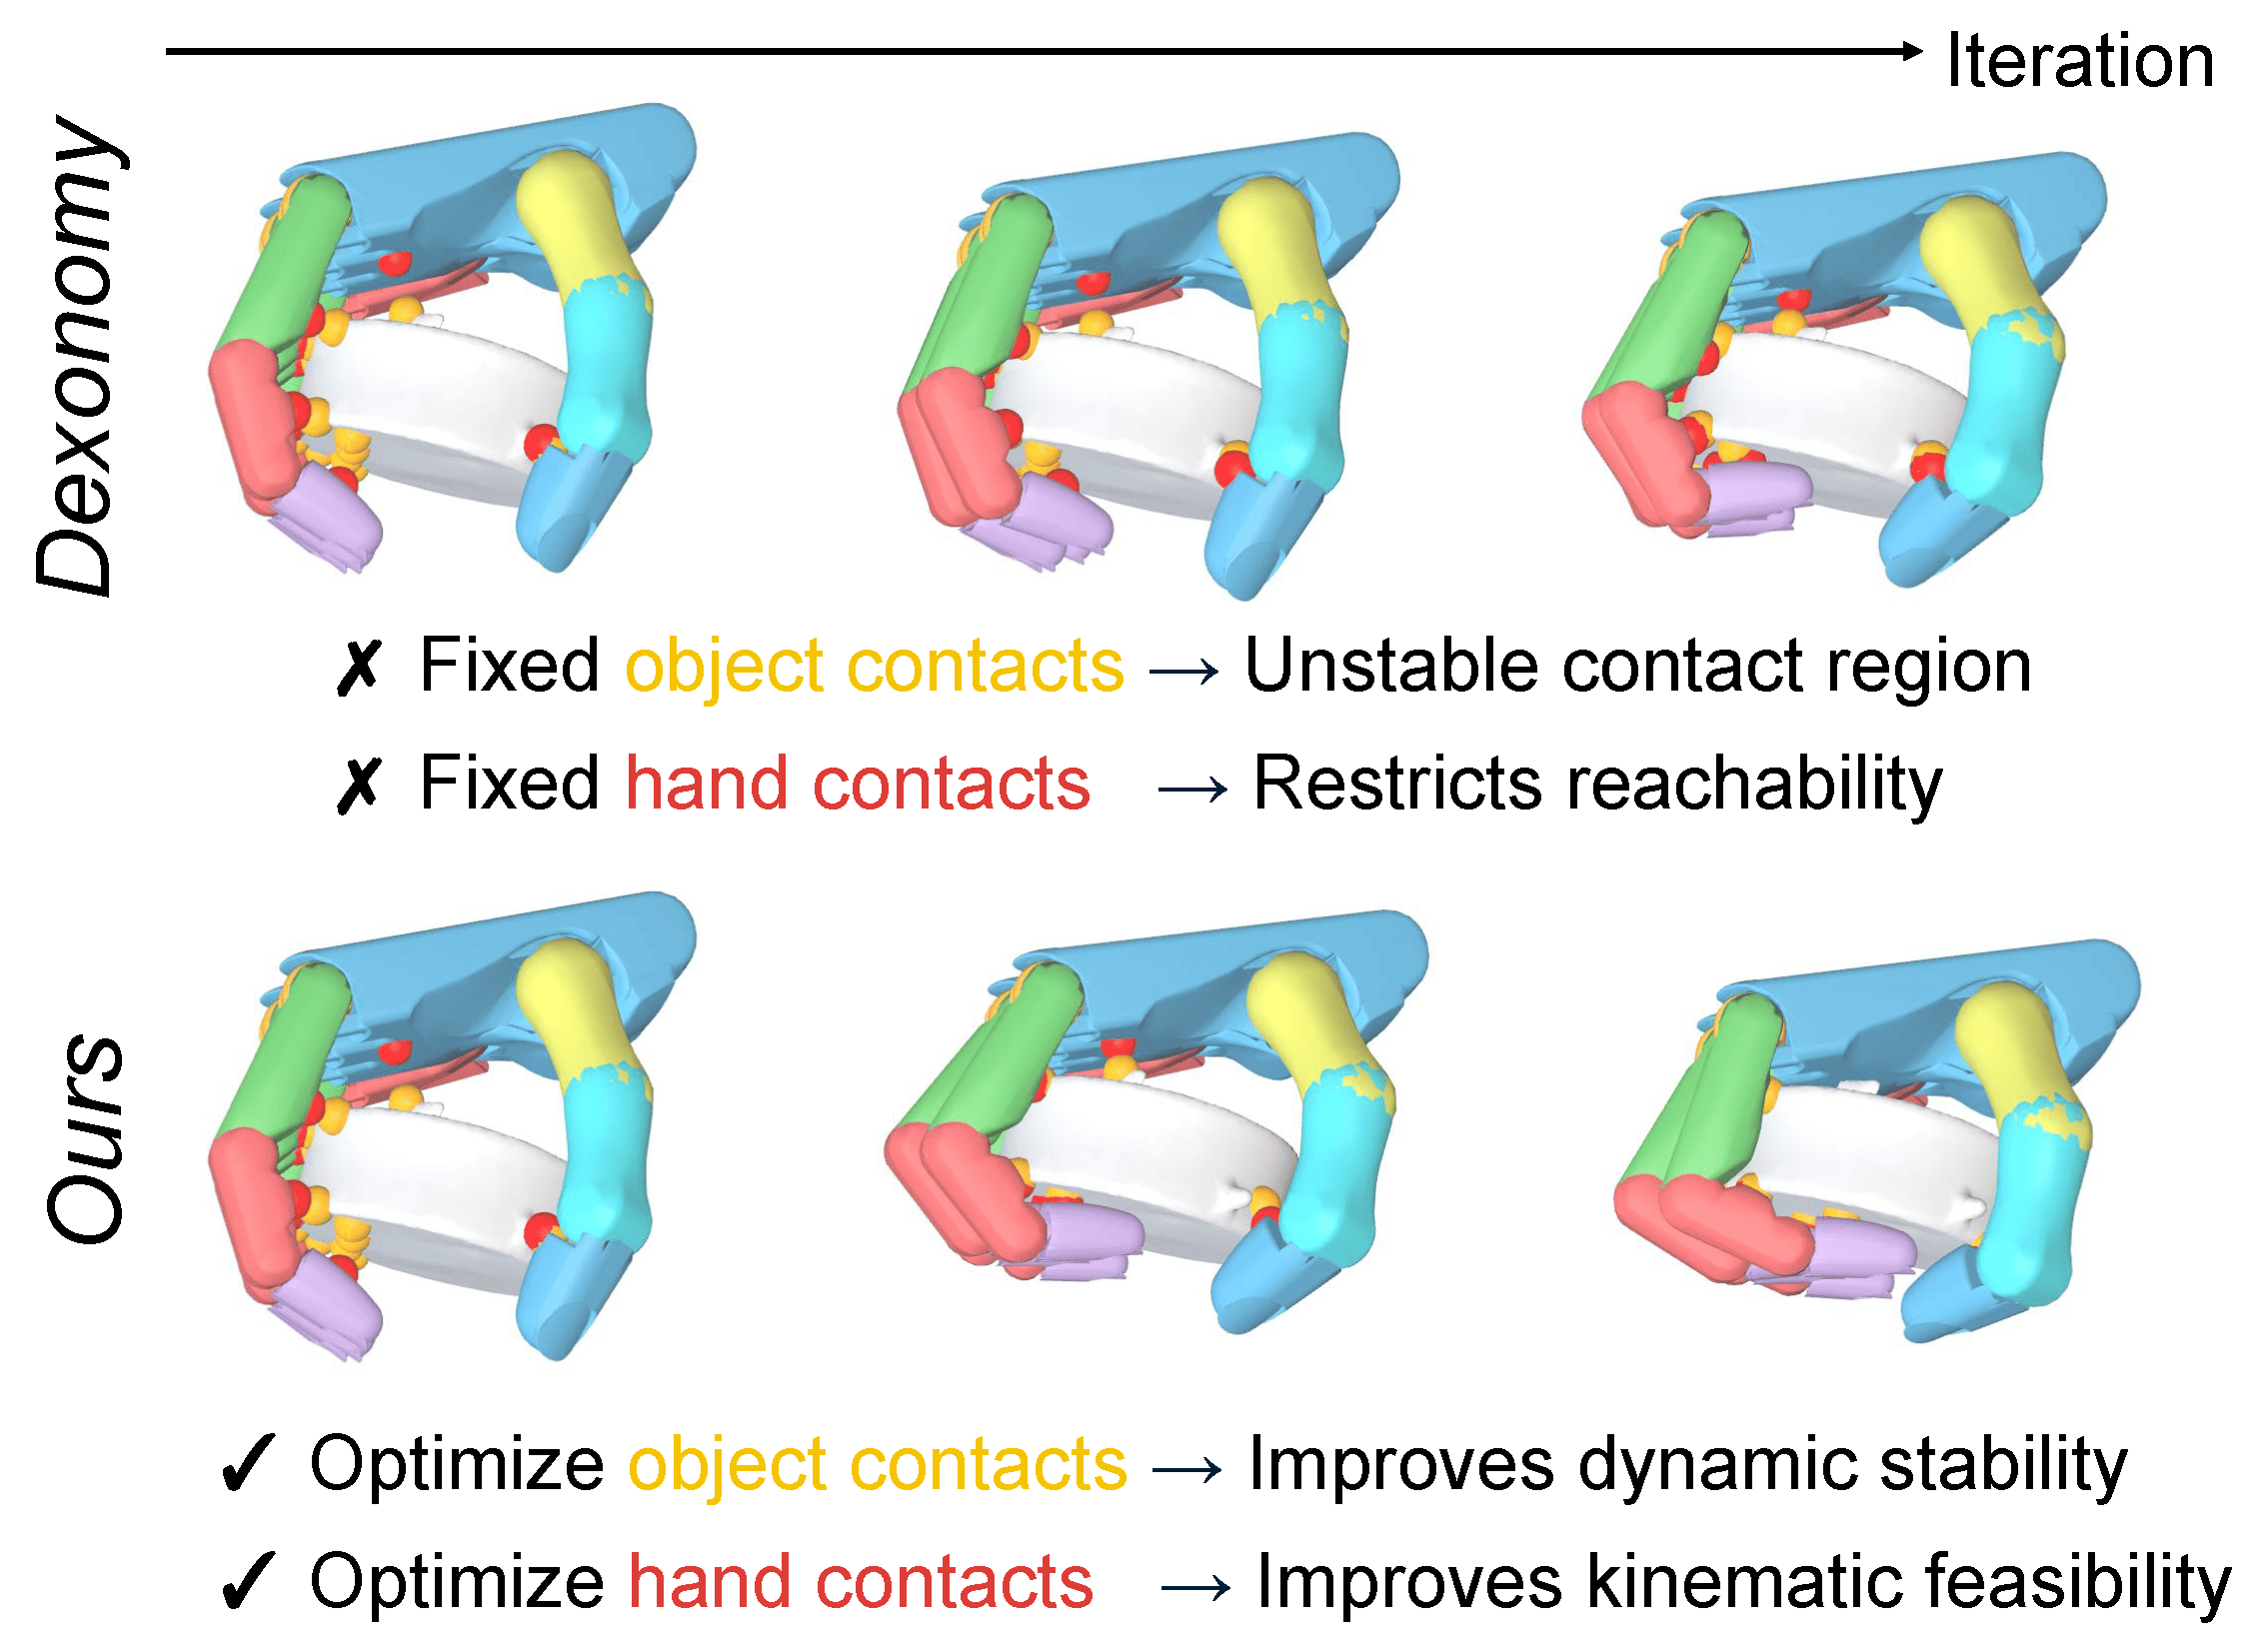
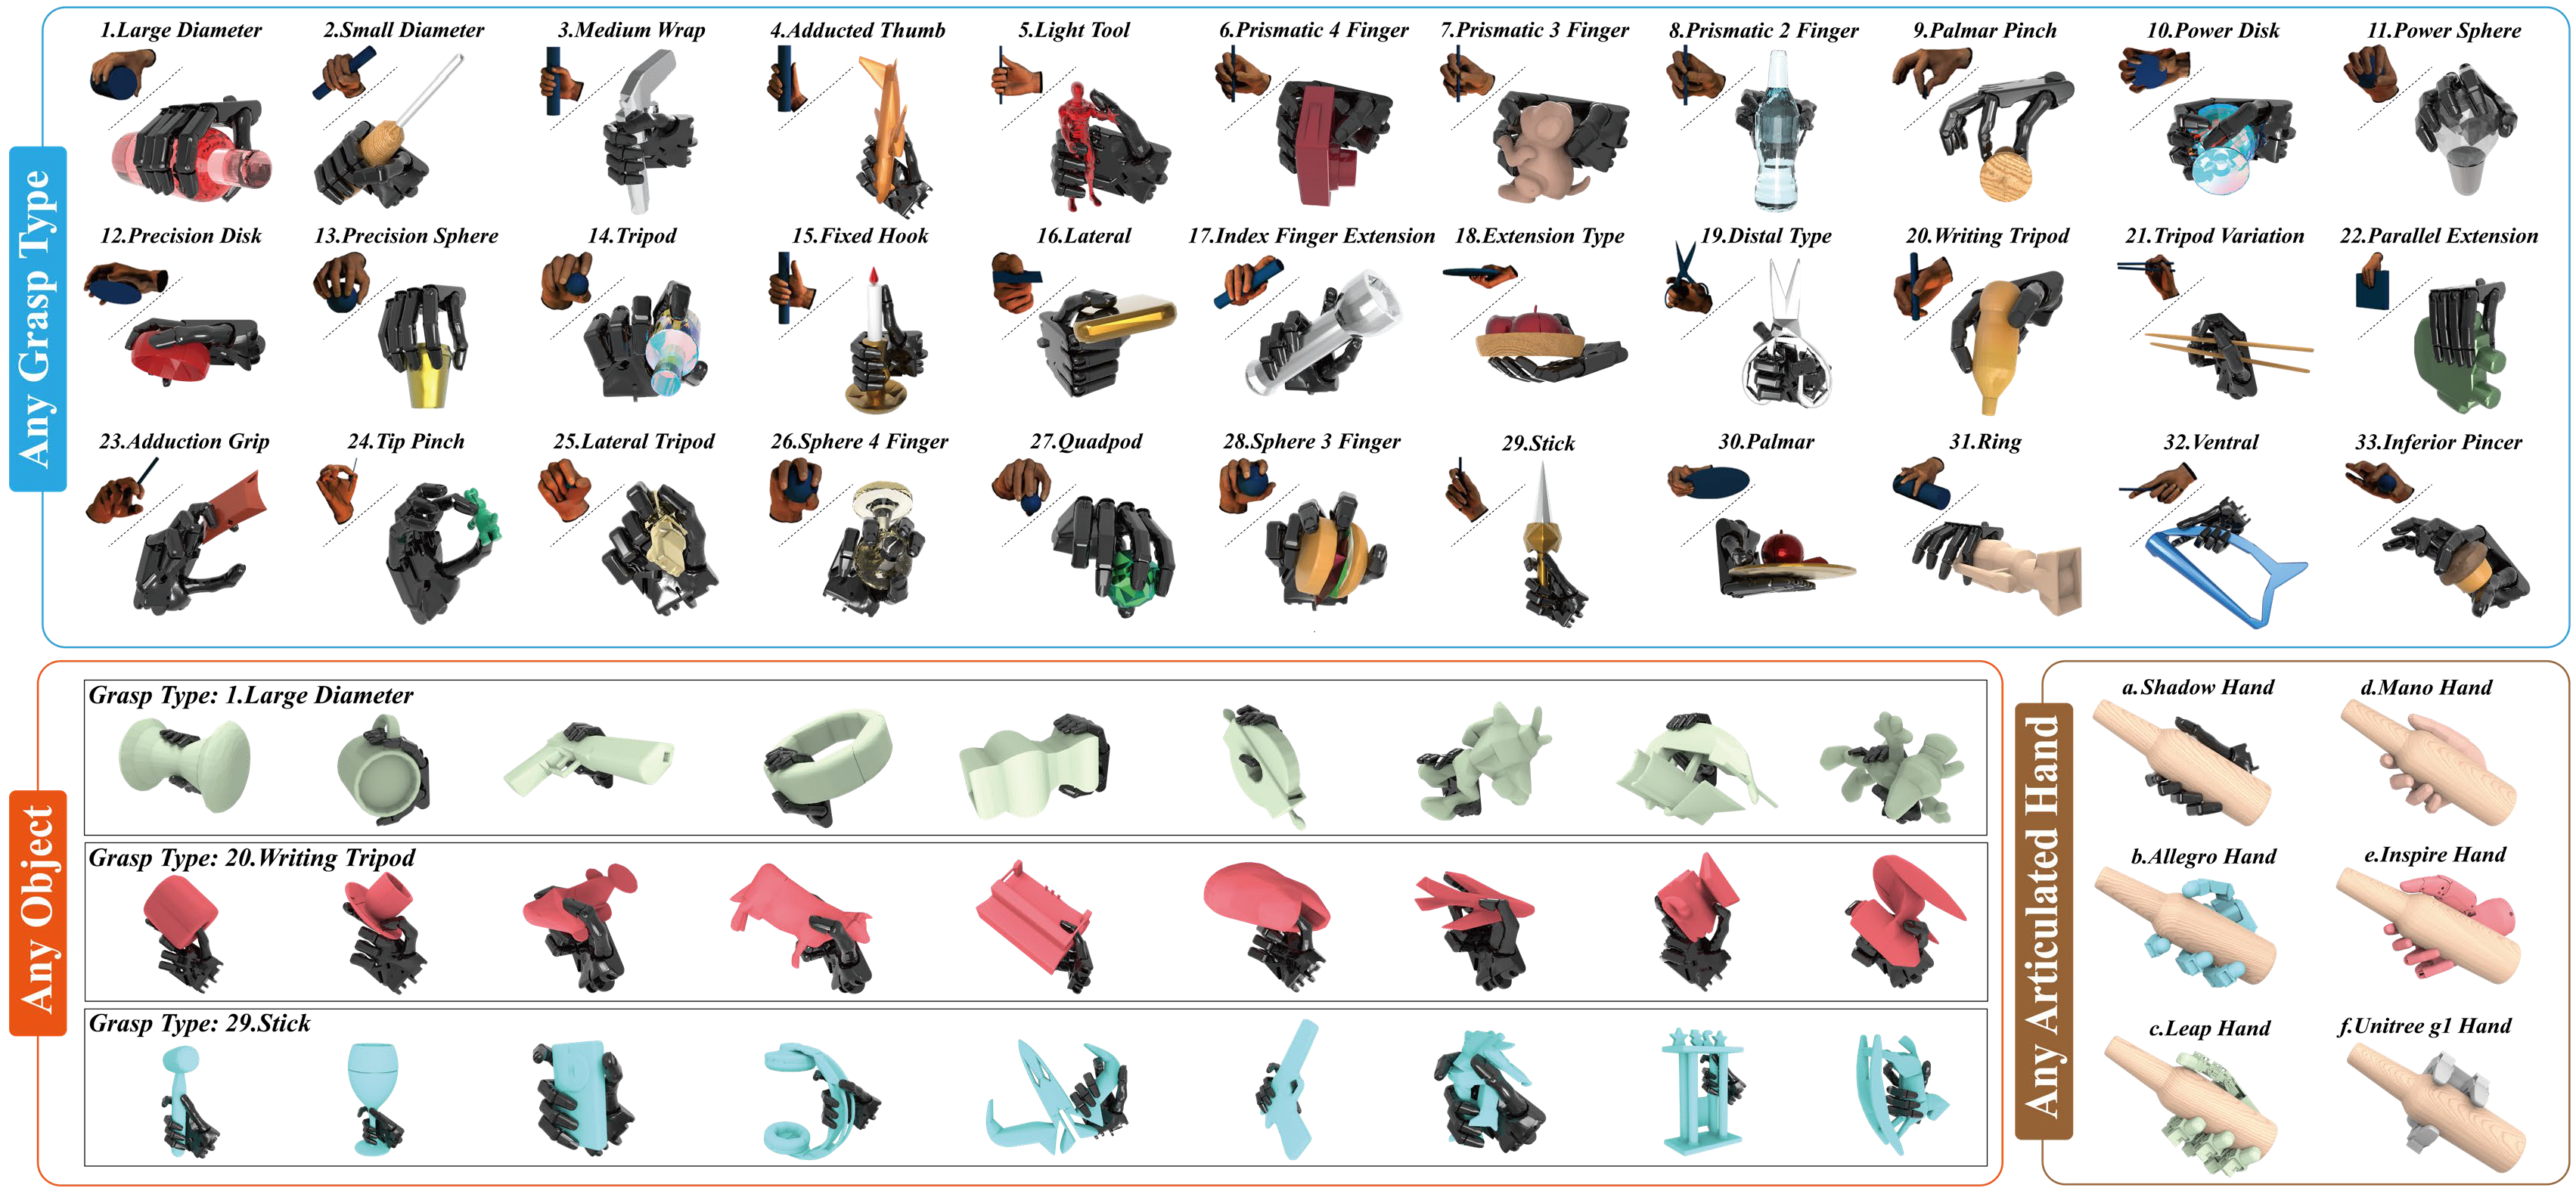
Dexonomy: Synthesizing All Dexterous Grasp Types in a Grasp
Taxonomy
              @article{chen2025dexonomy,
                title={Dexonomy: Synthesizing All Dexterous Grasp Types in a Grasp Taxonomy},
                author={Chen, Jiayi and Ke, Yubin and Peng, Lin and Wang, He},
                journal={Robotics: Science and Systems},
                year={2025}
              }
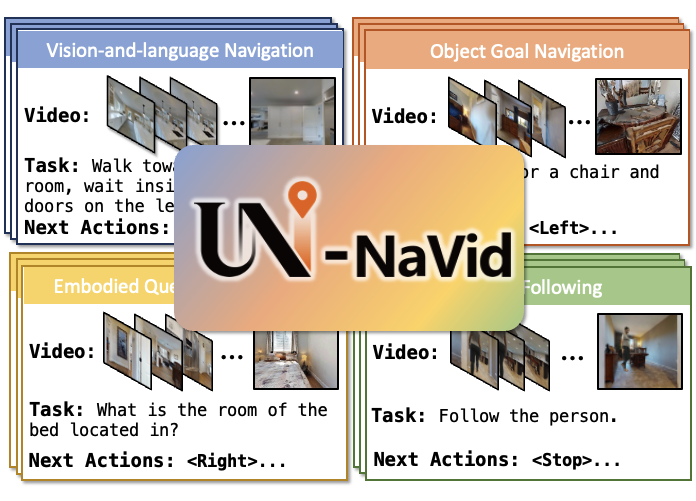
Uni-NaVid: A Video-based Vision-Language-Action Model for
Unifying Embodied Navigation Tasks
              @misc{zhang2024uninavid,
                title={Uni-NaVid: A Video-based Vision-Language-Action Model for Unifying Embodied Navigation Tasks},
                author={Jiazhao Zhang and Kunyu Wang and Shaoan Wang and Minghan Li and Haoran Liu and Songlin Wei and Zhongyuan Wang and Zhizheng Zhang and He Wang},
                year={2024},
                journal = {arXiv preprint arXiv:2412.06224}
              }
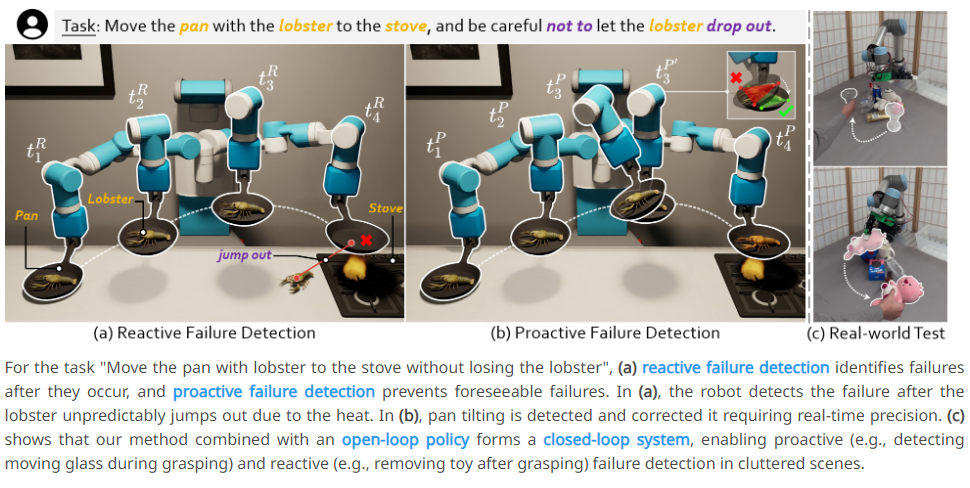
Code-as-Monitor: Constraint-aware Visual Programming for
Reactive and Proactive Robotic Failure Detection
Enshen Zhou*, Qi Su*, Cheng Chi*†,
Zhizheng Zhang, Zhongyuan Wang, Tiejun Huang, Lu
Sheng†,
He Wang†
              @article{zhou2024code,
                title={Code-as-Monitor: Constraint-aware Visual Programming for Reactive and Proactive Robotic Failure Detection},
                author={Zhou, Enshen and Su, Qi and Chi, Cheng and Zhang, Zhizheng and Wang, Zhongyuan and Huang, Tiejun and Sheng, Lu and Wang, He},
                journal={arXiv preprint arXiv:2412.04455},
                year={2024}
            }
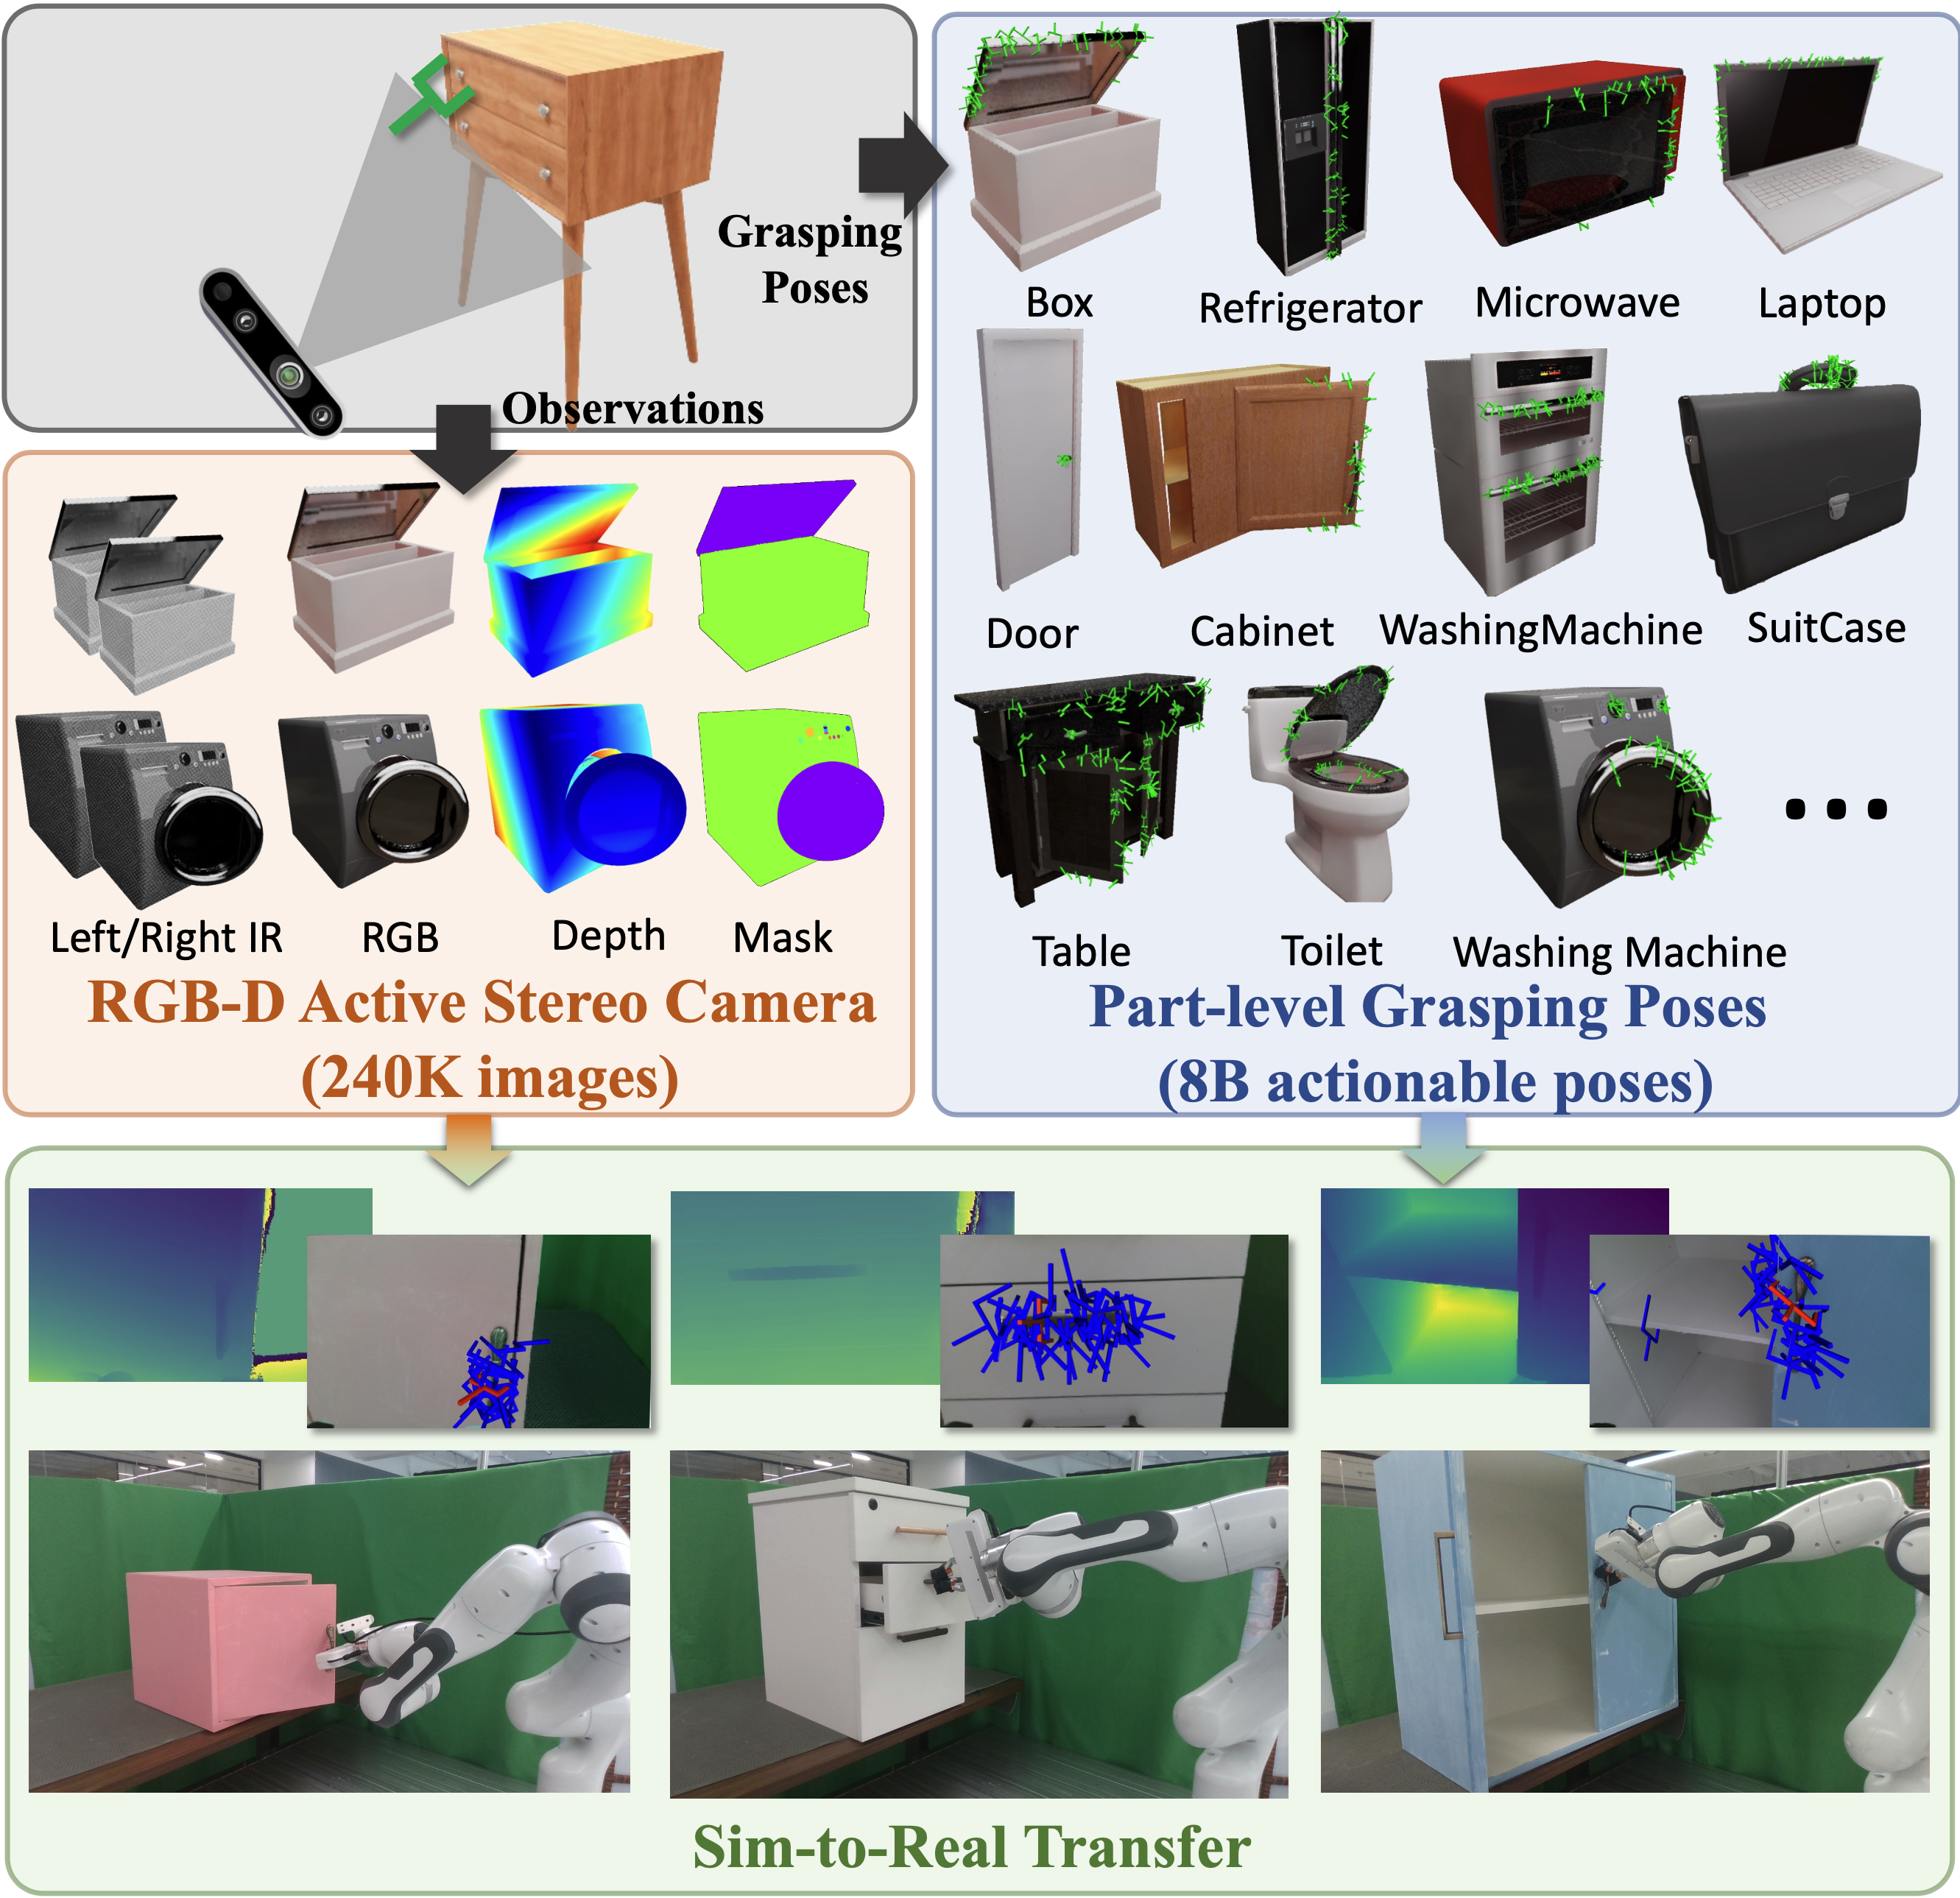
GAPartManip: A Large-scale Part-centric Dataset for
Material-Agnostic Articulated Object Manipulation
              @article{cui2024gapartmanip,
                title={GAPartManip: A Large-scale Part-centric Dataset for Material-Agnostic Articulated Object Manipulation},
                author={Cui, Wenbo and Zhao, Chengyang and Wei, Songlin and Zhang, Jiazhao and Geng, Haoran and Chen, Yaran and Wang, He},
                journal={arXiv preprint arXiv:2411.18276},
                year={2024}
              }
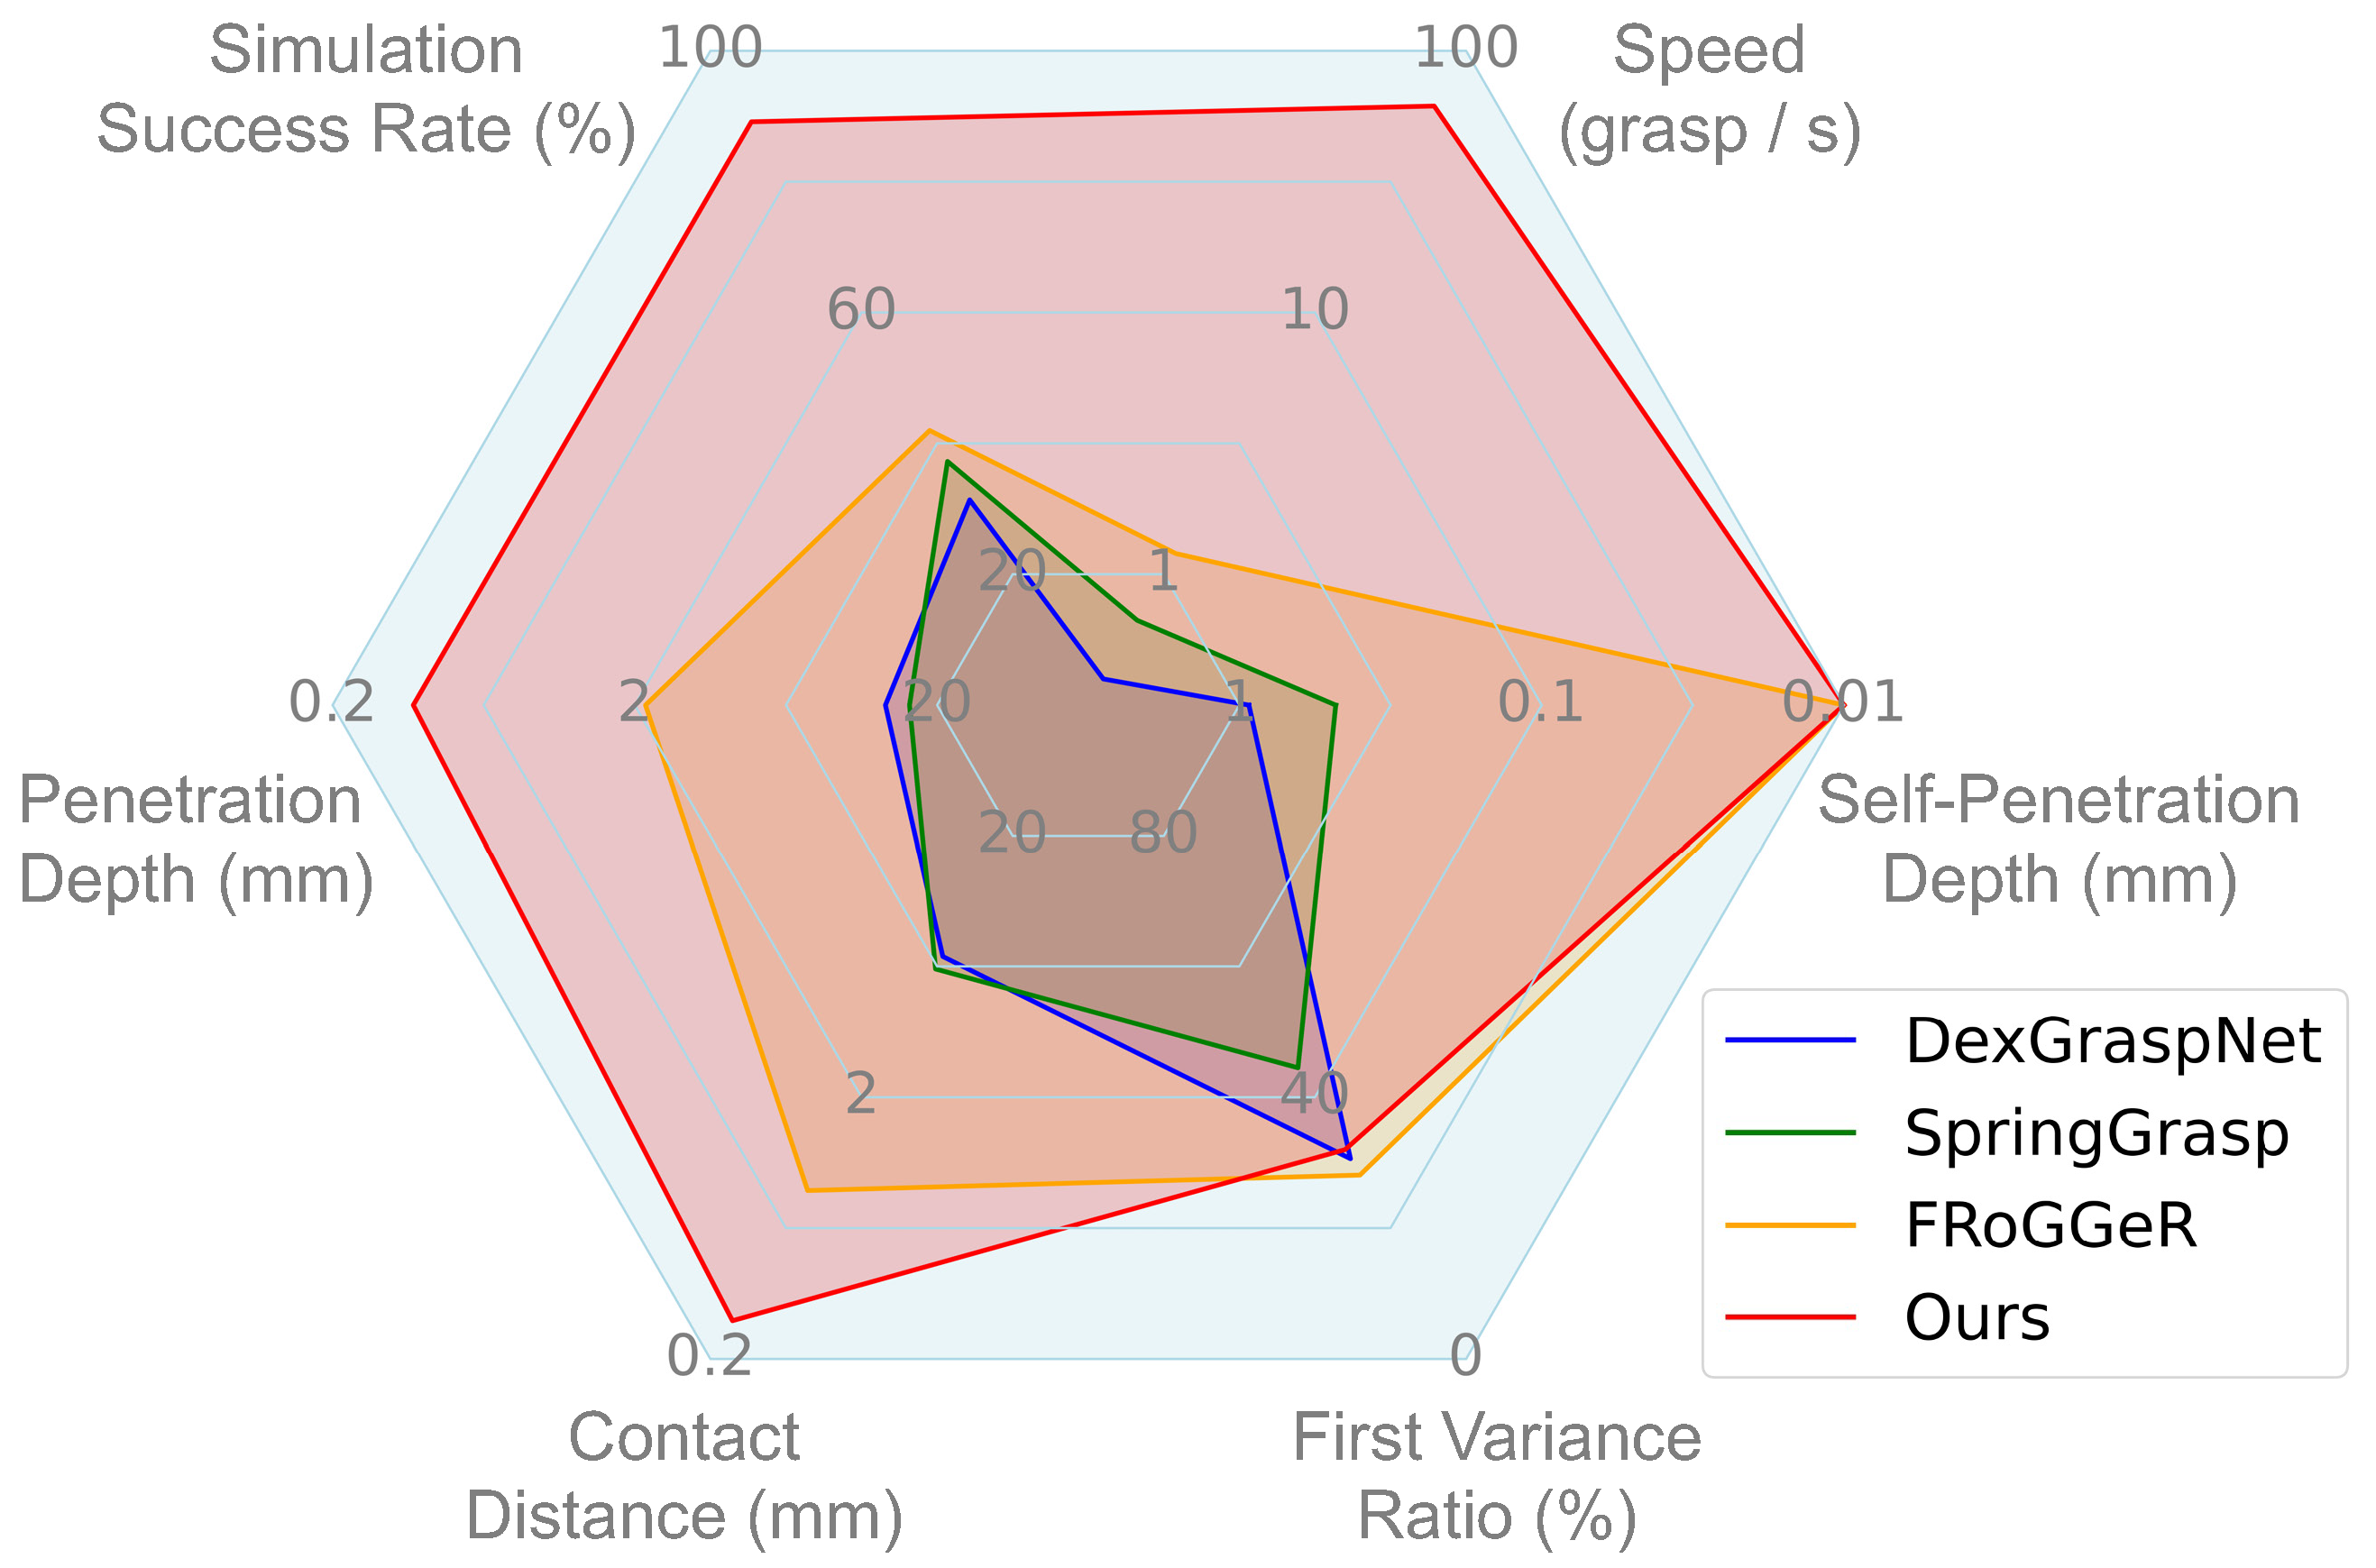
BODex: Scalable and Efficient Robotic Dexterous Grasp
Synthesis Using Bilevel Optimization
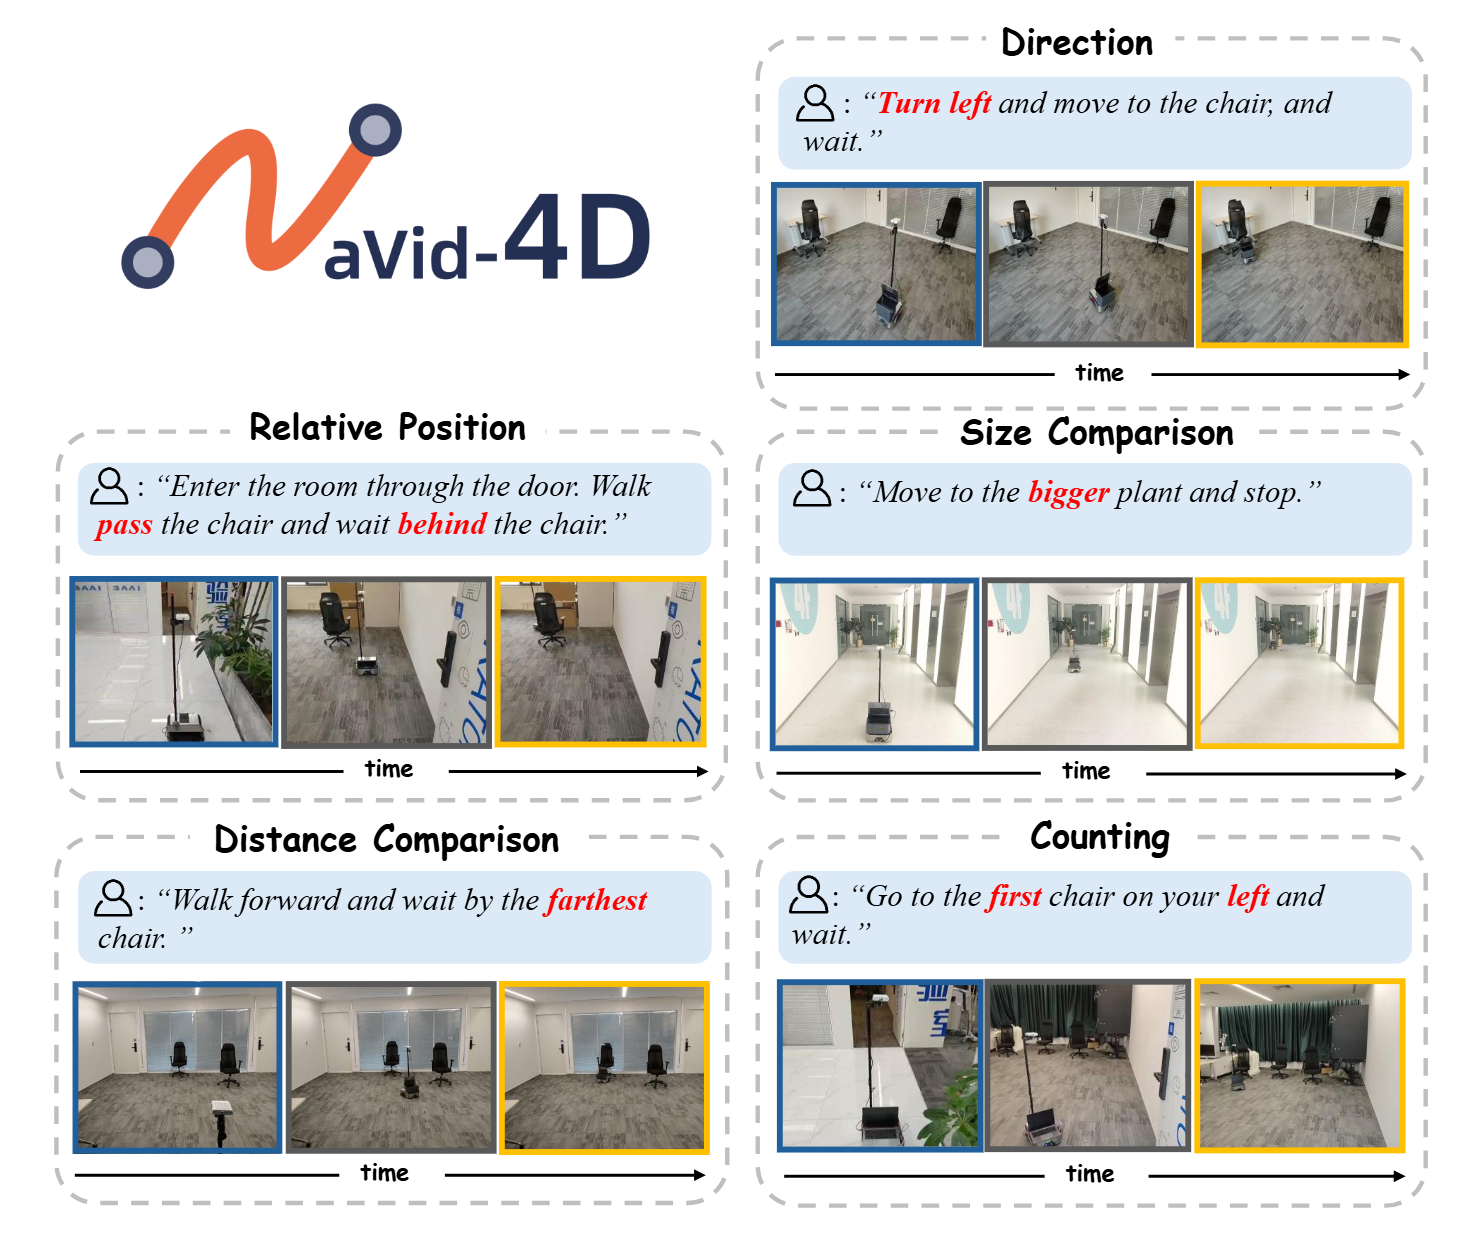
               @inproceedings{liu2025navid4d,
                  title={NaVid-4D: Unleashing Spatial Intelligence in Egocentric RGB-D Videos for Vision-and-Language Navigation},
                  author={Liu, Haoran and Wan, Weikang and Yu, Xiqian and Li, Minghan and Zhang, Jiazhao and Zhao,
                  Bo and Chen, Zhibo and Wang, Zhongyuan and Zhang, Zhizheng and Wang, He},
                  booktitle={2025 IEEE International Conference on Robotics and Automation (ICRA)}
                }
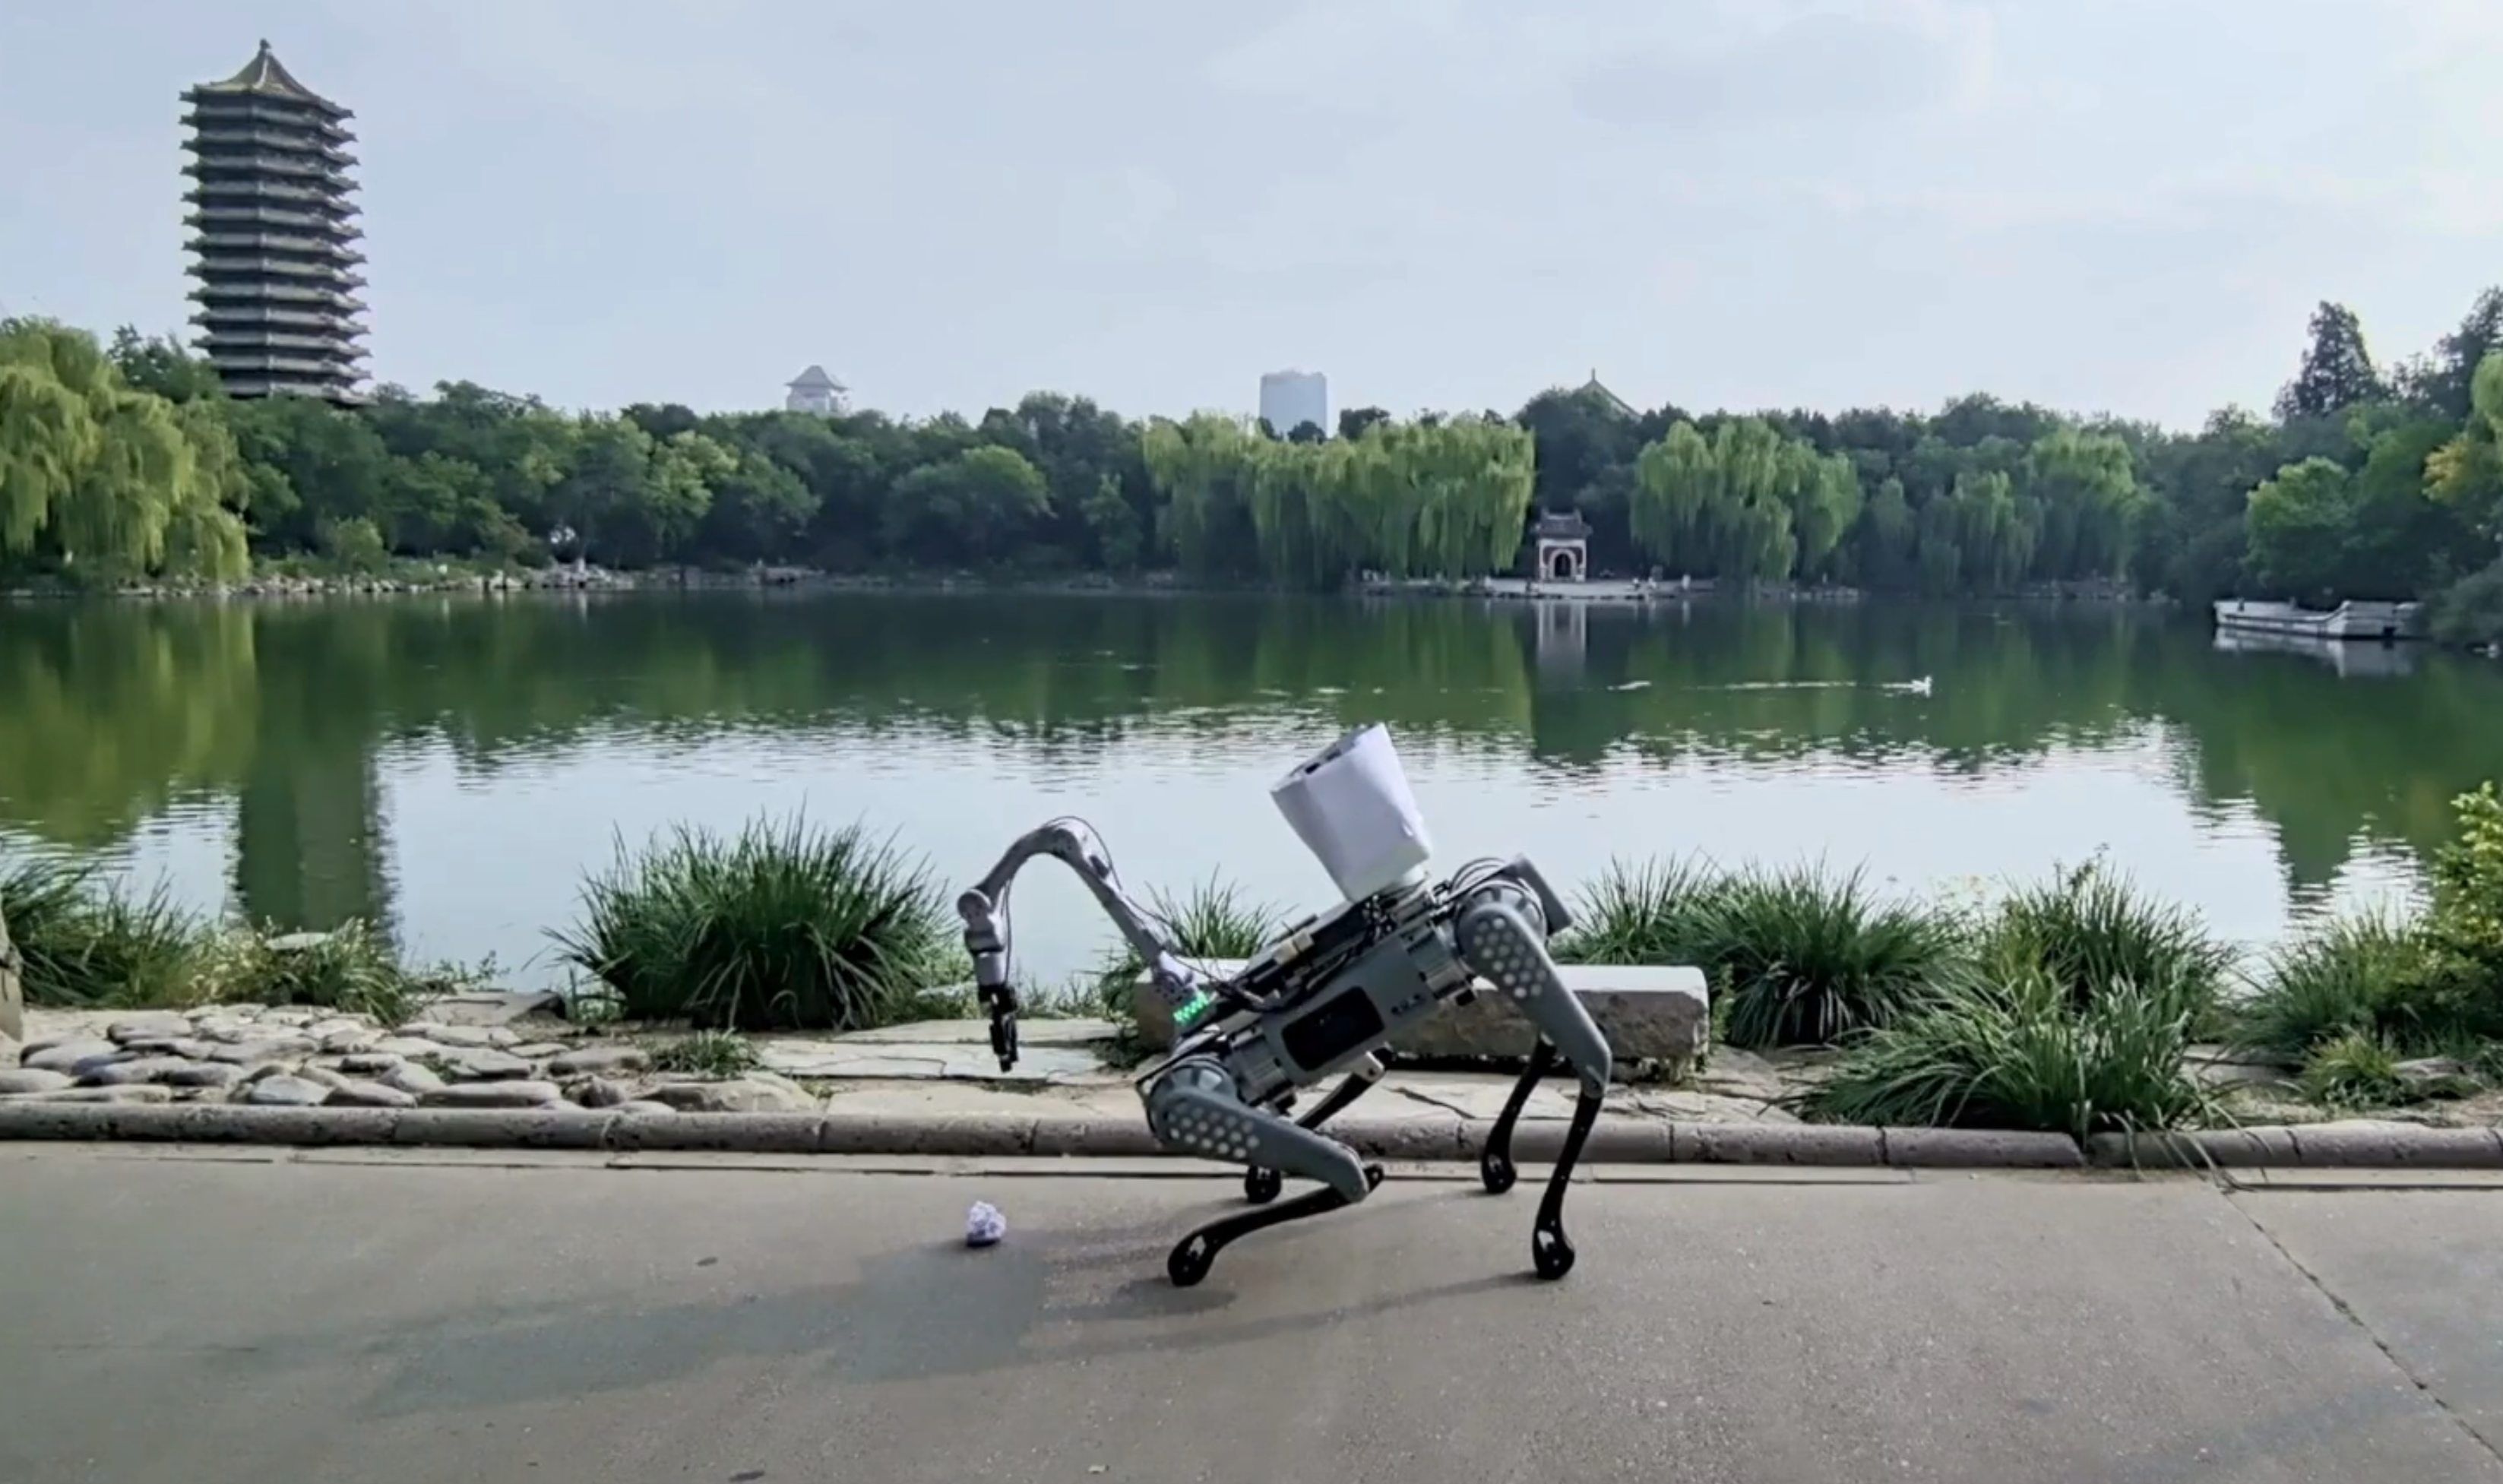
               @inproceedings{2024QuadWBG,
                title={QuadWBG: Generalizable Quadrupedal Whole-Body Grasping},
                author={ Wang, Jilong  and  Rajabov, Javokhirbek  and  Xu, Chaoyi  and  Zheng, Yiming  and  Wang, He },
                year={2024},
              }
Watch Less, Feel More: Direct Sim-to-real RL for Articulated
Object Manipulation with Motion Adaptation and Impedance
Control
Tan-Dzung Do, Gireesh Nandiraju, Jilong Wang,
He Wang†
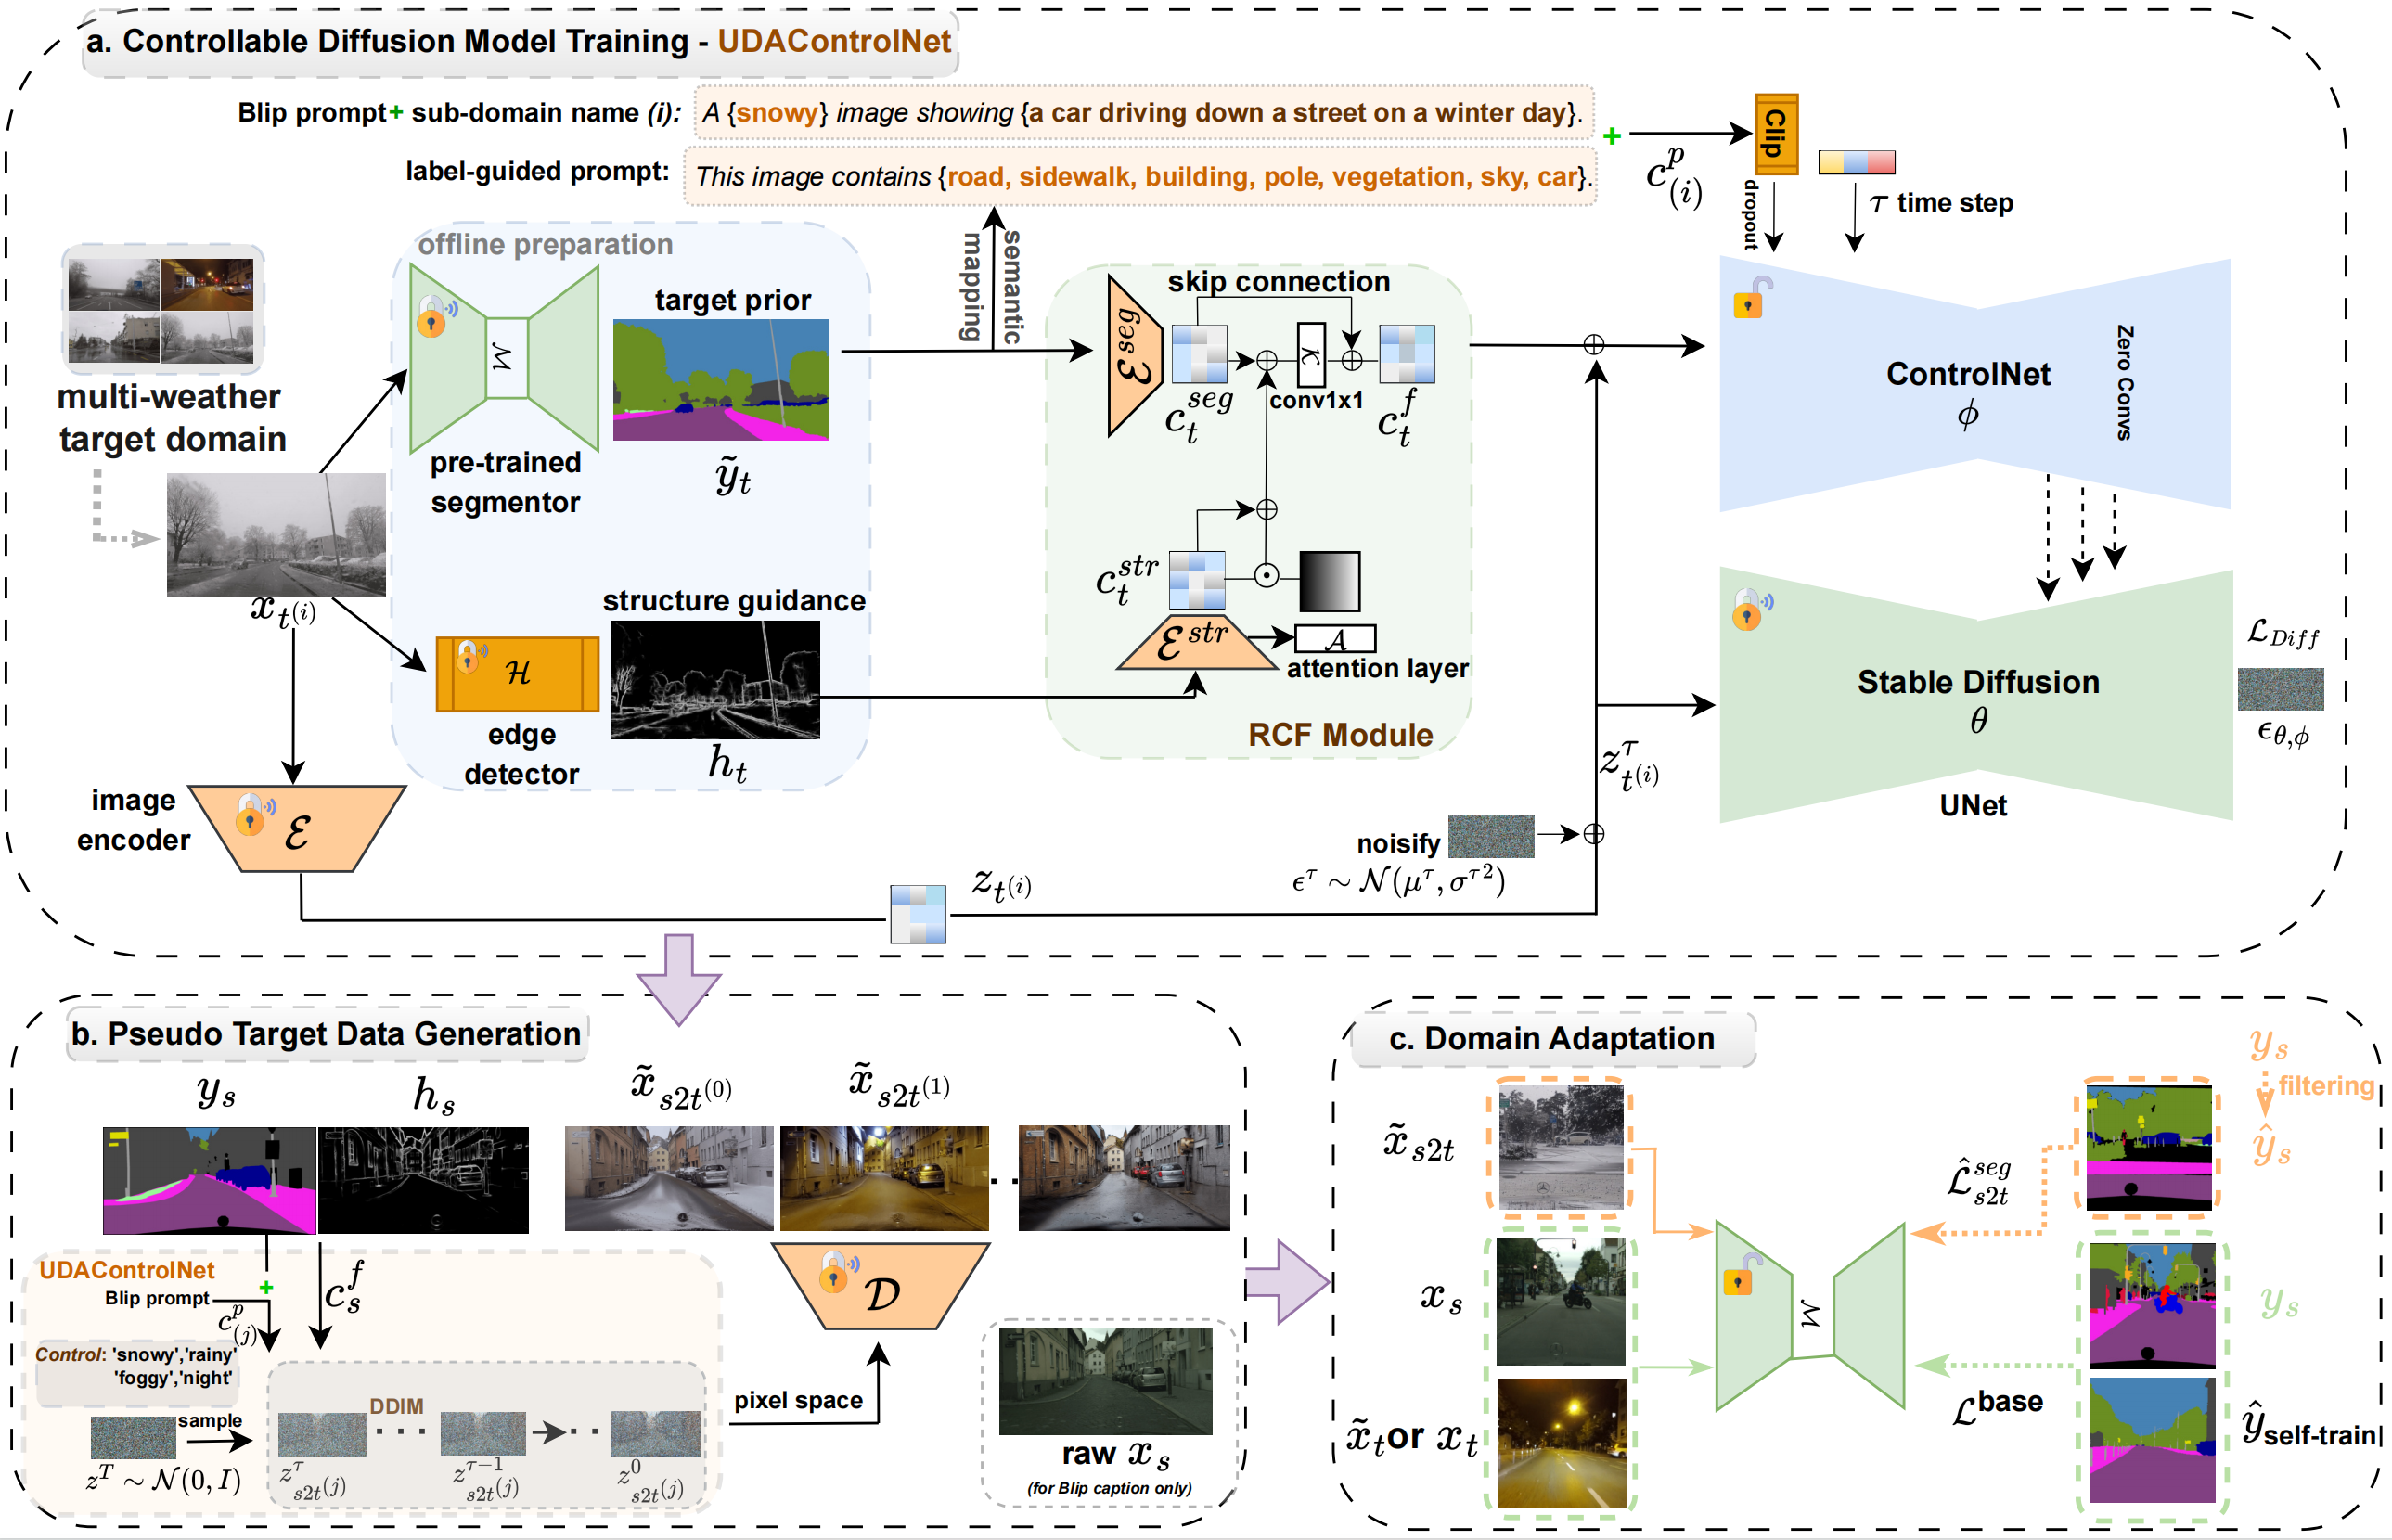
            @article{fengyi_2025,
              title={W-ControlUDA: Weather-Controllable Diffusion-assisted Unsupervised Domain Adaptation for Semantic Segmentation},
              author={Shen, Fengyi and Zhou, Li and Kuecuekaytekin, Kagan and Eskandar, George Basem Fouad and Liu, Ziyuan and Wang, He and Knoll, Alois},
              volume={10},
              url={http://dx.doi.org/10.1109/LRA.2025.3544925},
              doi={10.1109/lra.2025.3544925},
              number={5},
              journal={IEEE Robotics and Automation Letters},
              publisher={Institute of Electrical and Electronics Engineers (IEEE)},
              year={2025},
              month={May},
              pages={4204-4211},
            }
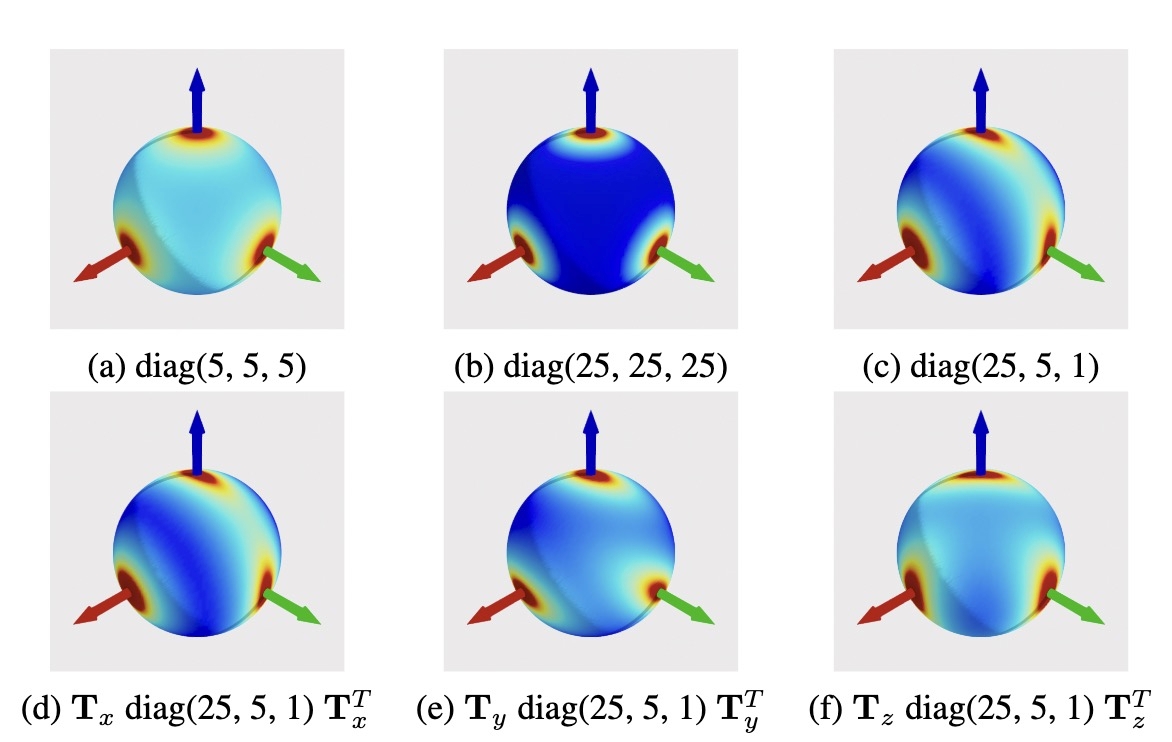
Towards Robust Probabilistic Modeling on SO(3) via Rotation
Laplace Distribution
Yingda Yin*, Jiangran Lyu*, Yang Wang,
He Wang†, Baoquan Chen†
            @article{yin2025towards,
              title={Towards robust probabilistic modeling on SO (3) via rotation laplace distribution},
              author={Yin, Yingda and Lyu, Jiangran and Wang, Yang and Liu, Haoran and Wang, He and Chen, Baoquan},
              journal={IEEE Transactions on Pattern Analysis and Machine Intelligence},
              year={2025},
              publisher={IEEE},
            }
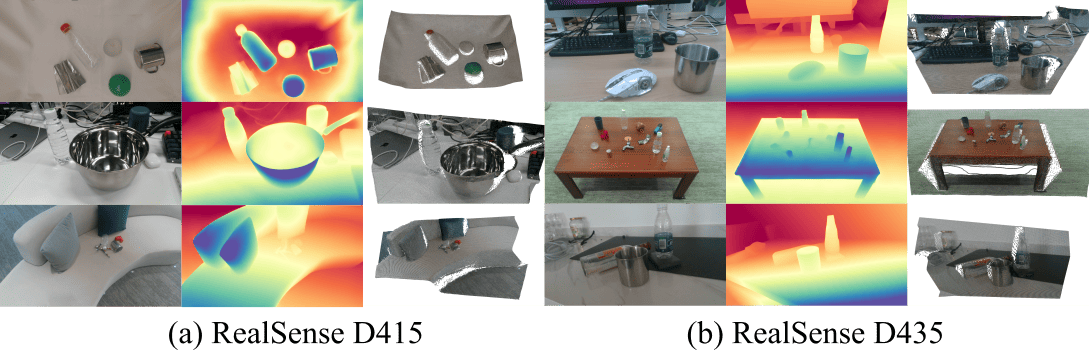
D3RoMa: Disparity Diffusion-based Depth Sensing
for Material-Agnostic Robotic Manipulation
Songlin Wei, Haoran Geng, Jiayi Chen, Congyue Deng, Wenbo
Cui, Chengyang Zhao, Xiaomeng Fang, Leonidas J. Guibas,
He Wang†
            @inproceedings{
              wei2024droma,
              title={D3RoMa: Disparity Diffusion-based Depth Sensing for Material-Agnostic Robotic Manipulation},
              author={Songlin Wei and Haoran Geng and Jiayi Chen and Congyue Deng and Cui Wenbo and Chengyang Zhao and Xiaomeng Fang and Leonidas Guibas and He Wang},
              booktitle={8th Annual Conference on Robot Learning},
              year={2024},
              url={https://openreview.net/forum?id=7E3JAys1xO}
            }
             @inproceedings{zhangdexgraspnet,
              title={DexGraspNet 2.0: Learning Generative Dexterous Grasping in Large-scale Synthetic Cluttered Scenes},
              author={Zhang, Jialiang and Liu, Haoran and Li, Danshi and Yu, XinQiang and Geng, Haoran and Ding, Yufei and Chen, Jiayi and Wang, He},
              booktitle={8th Annual Conference on Robot Learning}
            }
ScissorBot: Learning Generalizable Scissor Skill for Paper
Cutting via Simulation, Imitation, and Sim2Real
Jiangran Lyu, Yuxing Chen, Tao Du, Feng Zhu, Huiquan Liu,
Yizhou Wang†, He Wang†
             @inproceedings{lyuscissorbot,
                title =     {ScissorBot: Learning Generalizable Scissor Skill for Paper Cutting via Simulation, Imitation, and Sim2Real},
                author =    {Lyu, Jiangran and Chen, Yuxing and Du, Tao and Zhu, Feng and Liu, Huiquan and Wang, Yizhou and Wang, He},
                booktitle=  {8th Annual Conference on Robot Learning}
              }
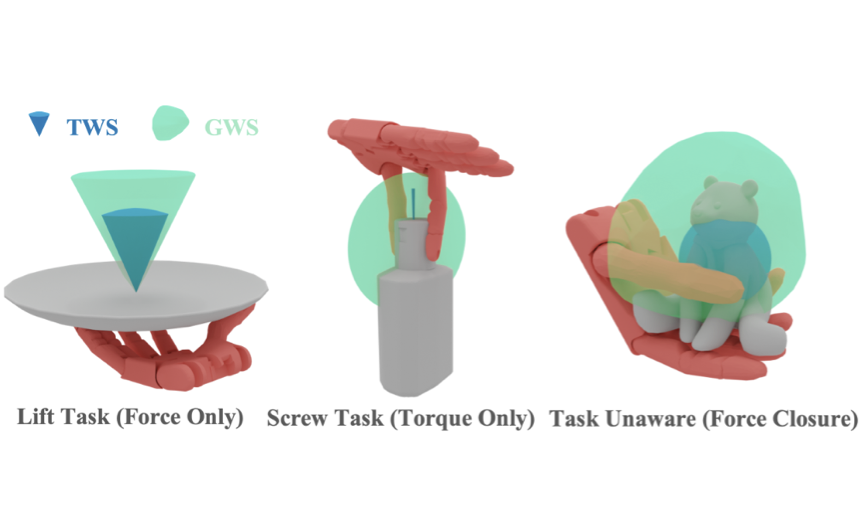
Task-Oriented Dexterous Grasp Synthesis via Differentiable
Grasp Wrench Boundary Estimator
            @INPROCEEDINGS{10802733,
              author={Ding, Yufei and Geng, Haoran and Xu, Chaoyi and Fang, Xiaomeng and Zhang, Jiazhao and Wei, Songlin and Dai, Qiyu and Zhang, Zhizheng and Wang, He},
              booktitle={2024 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS)},
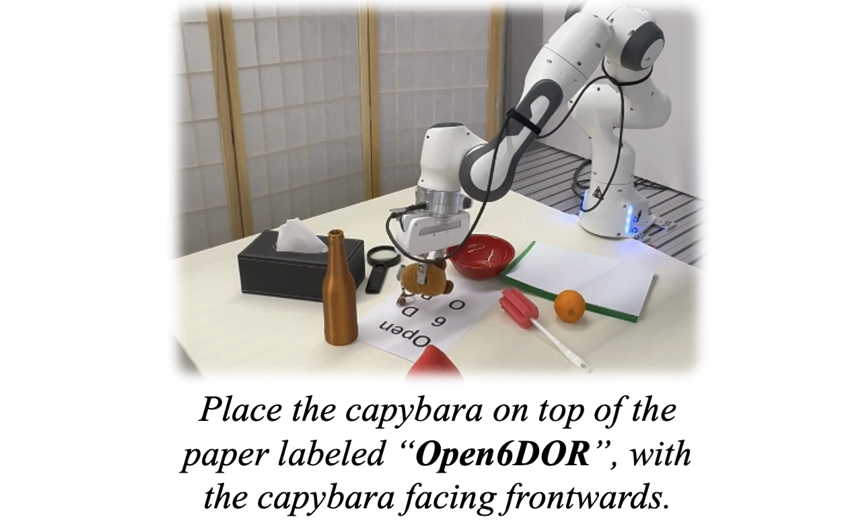
              title={Open6DOR: Benchmarking Open-instruction 6-DoF Object Rearrangement and A VLM-based Approach},
              year={2024},
              volume={},
              number={},
              pages={7359-7366},
              keywords={Three-dimensional displays;Benchmark testing;Propulsion;6-DOF;Real-time systems;Artificial intelligence;Intelligent robots;Synthetic data},
              doi={10.1109/IROS58592.2024.10802733}
            }
NaVid: Video-based VLM Plans the Next Step for
Vision-and-Language Navigation
            @article{zhang2024navid,
              title={NaVid: Video-based VLM Plans the Next Step for Vision-and-Language Navigation},
              author={Zhang, Jiazhao and Wang, Kunyu and Xu, Rongtao and Zhou, Gengze and Hong, Yicong and Fang, Xiaomeng and Wu, Qi and Zhang, Zhizheng and Wang, He},
              journal={Robotics: Science and Systems},
              year={2024}
            }
SAGE: Bridging Semantic and Actionable Parts for
Generalizable Manipulation of Articulated Objects
Haoran Geng*, Songlin Wei*, Congyue Deng, Bokui Shen,
He Wang†, Leonidas J. Guibas†
            @misc{geng2023sage,
              title={SAGE: Bridging Semantic and Actionable Parts for GEneralizable Articulated-Object Manipulation under Language Instructions},
              author={Haoran Geng and Songlin Wei and Congyue Deng and Bokui Shen and He Wang and Leonidas Guibas},
              year={2023},
              eprint={2312.01307},
              archivePrefix={arXiv},
              primaryClass={cs.RO}
            }
MaskClustering: View Consensus based Mask Graph Clustering
for Open-Vocabulary 3D Instance Segmentation
            @INPROCEEDINGS{10658542,
              author={Yan, Mi and Zhang, Jiazhao and Zhu, Yan and Wang, He},
              booktitle={2024 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR)},
              title={MaskClustering: View Consensus Based Mask Graph Clustering for Open-Vocabulary 3D Instance Segmentation},
              year={2024},
              volume={},
              number={},
              pages={28274-28284},
              keywords={Measurement;Instance segmentation;Solid modeling;Computer vision;Three-dimensional displays;Shape;Navigation;3D instance segmentation;open-vocabulary},
              doi={10.1109/CVPR52733.2024.02671}
            }
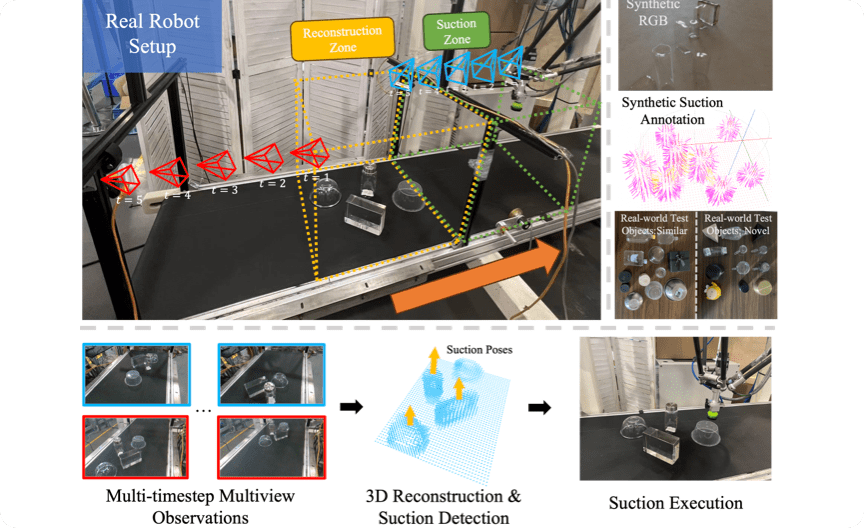
STOPNet: Multiview-based 6-DoF Suction Detection for
Transparent Objects on Production Lines
Yuxuan Kuang*, Qin Han*, Danshi Li, Qiyu Dai, Lian Ding,
Dong Sun, Hanlin Zhao,
He Wang†
            @inproceedings{kuang2023stopnet,
              title={STOPNet: Multiview-based 6-DoF Suction Detection for Transparent Objects on Production Lines},
              author={Kuang, Yuxuan and Han, Qin and Li, Danshi and Dai, Qiyu and Ding, Lian and Sun, Dong and Zhao, Hanlin and Wang, He},
              booktitle={2024 IEEE International Conference on Robotics and Automation (ICRA)},
              year={2024},
              organization={IEEE}
            }
GAMMA: Graspability-Aware Mobile MAnipulation Policy
Learning based on Online Grasping Pose Fusion
Jiazhao Zhang*, Nandiraju Gireesh*, Jilong Wang, Xiaomeng
Fang, Chaoyi Xu, Weiguang Chen, Liu Dai,
He Wang†
            @misc{zhang2023gamma,
              title={GAMMA: Graspability-Aware Mobile MAnipulation Policy Learning based on Online Grasping Pose Fusion},
              author={Jiazhao Zhang and Nandiraju Gireesh and Jilong Wang and Xiaomeng Fang and Chaoyi Xu and Weiguang Chen and Liu Dai and He Wang},
              year={2023},
              eprint={2309.15459},
              archivePrefix={arXiv},
              primaryClass={cs.RO}
            }
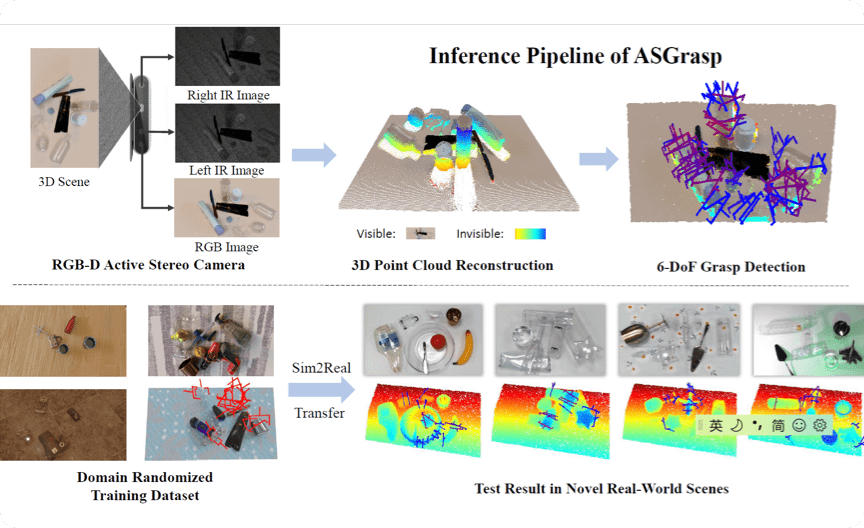
ASGrasp: Generalizable Transparent Object Reconstruction and
6-DoF Grasp Detection from RGB-D Active Stereo Camera
Jun Shi, Yong A, Yixiang Jin, Dingzhe Li, Haoyu Niu, Zhezhu
Jin,
He Wang†
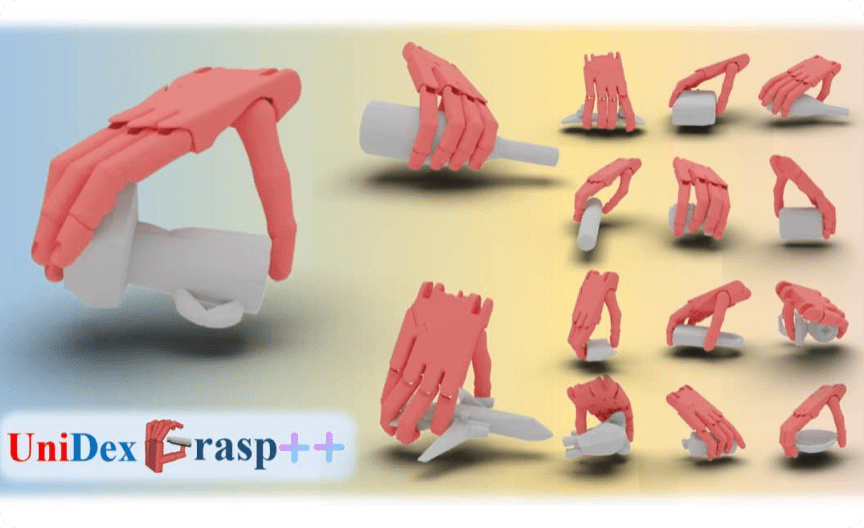
            @article{wan2023unidexgrasp++,
              title={UniDexGrasp++: Improving Dexterous Grasping Policy Learning via Geometry-aware Curriculum and Iterative Generalist-Specialist Learning},
              author={Wan, Weikang and Geng, Haoran and Liu, Yun and Shan, Zikang and Yang, Yaodong and Yi, Li and Wang, He},
              journal={arXiv preprint arXiv:2304.00464},
              year={2023}
            }
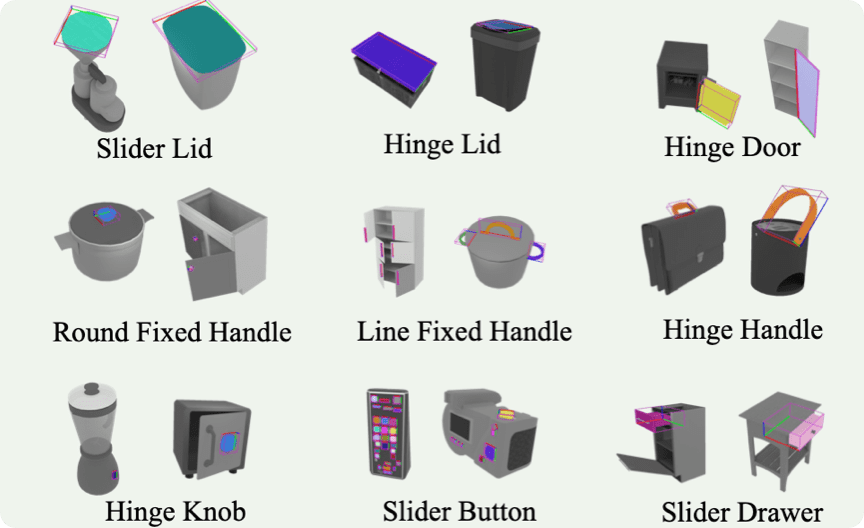
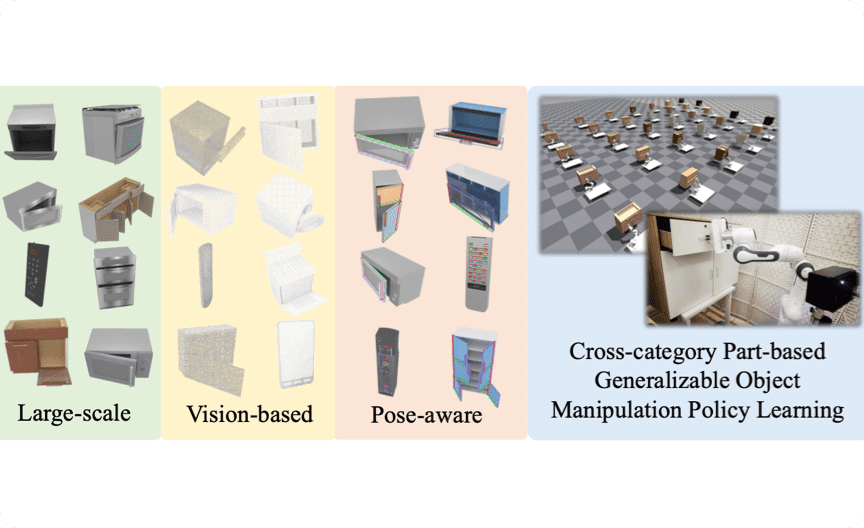
GAPartNet: Cross-Category Domain-Generalizable Object
Perception and Manipulation via Generalizable and Actionable
Parts
Haoran Geng*, Helin Xu*, Chengyang Zhao*, Chao Xu, Li Yi,
Siyuan Huang,
He Wang†
              @article{geng2022gapartnet,
                title={GAPartNet: Cross-Category Domain-Generalizable Object Perception and Manipulation via Generalizable and Actionable Parts},
                author={Geng, Haoran and Xu, Helin and Zhao, Chengyang and Xu, Chao and Yi, Li and Huang, Siyuan and Wang, He},
                journal={arXiv preprint arXiv:2211.05272},
                year={2022}
              }
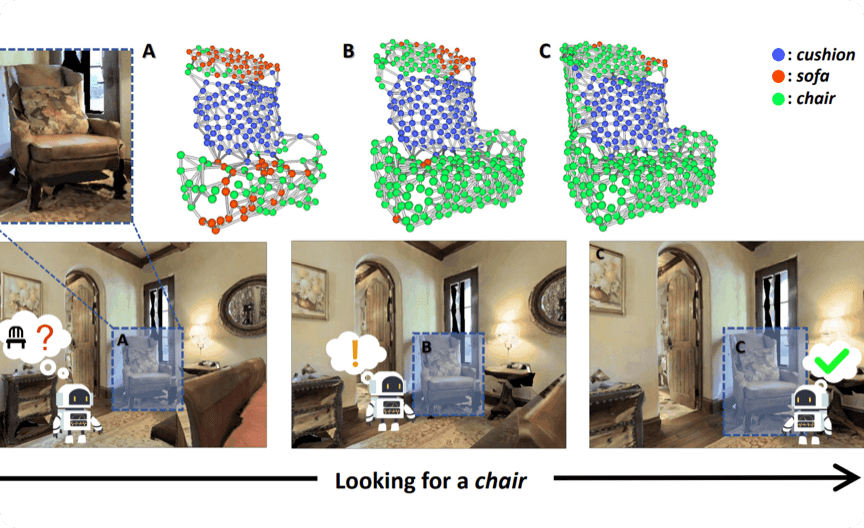
3D-Aware Object Goal Navigation via Simultaneous Exploration
and Identification
Jiazhao Zhang*, Liu Dai*, Fanpeng Meng, Qingnan Fan, Xuelin
Chen, Kai Xu,
He Wang†
              @article{zhang20223d,
                title={3D-Aware Object Goal Navigation via Simultaneous Exploration and Identification},
                author={Zhang, Jiazhao and Dai, Liu and Meng, Fanpeng and Fan, Qingnan and Chen, Xuelin and Xu, Kai and Wang, He},
                journal={arXiv preprint arXiv:2212.00338},
                year={2022}
              }
UniDexGrasp: Universal Robotic Dexterous Grasping via
Learning Diverse Proposal Generation and Goal-Conditioned
Policy
              @article{xu2023unidexgrasp,
                title={UniDexGrasp: Universal Robotic Dexterous Grasping via Learning Diverse Proposal Generation and Goal-Conditioned Policy},
                author={Xu, Yinzhen and Wan, Weikang and Zhang, Jialiang and Liu, Haoran and Shan, Zikang and Shen, Hao and Wang, Ruicheng and Geng, Haoran and Weng, Yijia and Chen, Jiayi and others},
                journal={arXiv preprint arXiv:2303.00938},
                year={2023}
              }
PartManip: Learning Cross-Category Generalizable Part
Manipulation Policy from Point Cloud Observations
              @article{geng2023partmanip,
                title={PartManip: Learning Cross-Category Generalizable Part Manipulation Policy from Point Cloud Observations},
                author={Geng, Haoran and Li, Ziming and Geng, Yiran and Chen, Jiayi and Dong, Hao and Wang, He},
                journal={arXiv preprint arXiv:2303.16958},
                year={2023}
              }
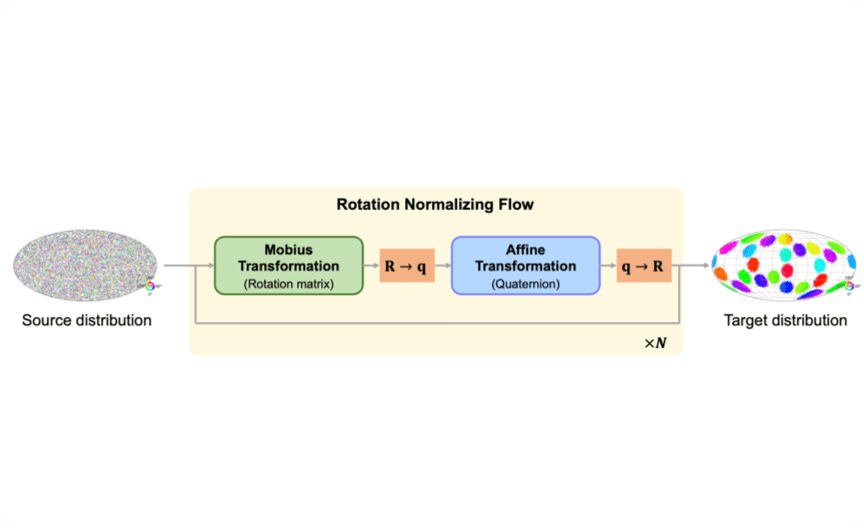
Delving into Discrete Normalizing Flows on SO(3) Manifold
for Probabilistic Rotation Modeling
Yulin Liu*, Haoran Liu*, Yingda Yin*, Yang Wang, Baoquan
Chen†,
He Wang†
            @article{liu2023delving,
              title={Delving into Discrete Normalizing Flows on SO (3) Manifold for Probabilistic Rotation Modeling},
              author={Liu, Yulin and Liu, Haoran and Yin, Yingda and Wang, Yang and Chen, Baoquan and Wang, He},
              journal={arXiv preprint arXiv:2304.03937},
              year={2023}
            }
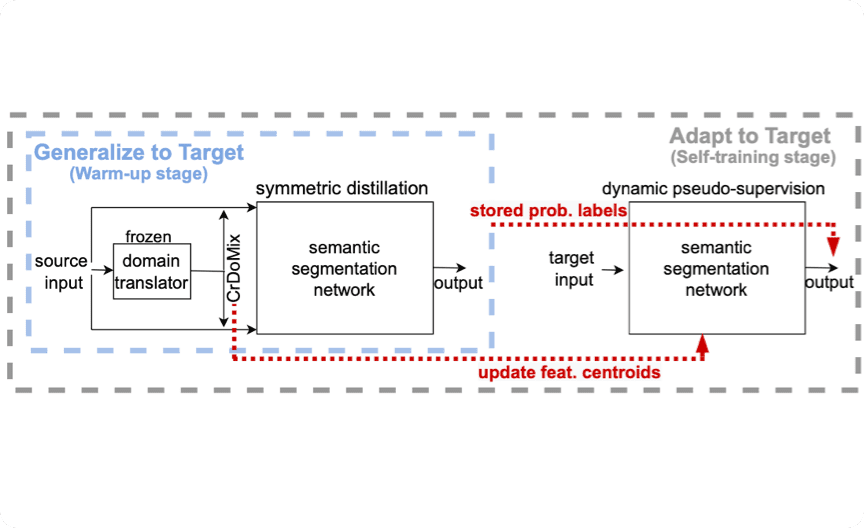
DiGA: Distil to Generalize and then Adapt for Domain
Adaptive Semantic Segmentation
Fengyi Shen, Akhil Gurram, Ziyuan Liu,
He Wang†, Alois Knoll†
              @article{shen2023diga,
                title={DiGA: Distil to Generalize and then Adapt for Domain Adaptive Semantic Segmentation},
                author={Shen, Fengyi and Gurram, Akhil and Liu, Ziyuan and Wang, He and Knoll, Alois},
                journal={arXiv preprint arXiv:2304.02222},
                year={2023}
              }
DexGraspNet: A Large-Scale Robotic Dexterous Grasp Dataset
for General Objects Based on Simulation
              @article{2210.02697,
                title = {DexGraspNet: A Large-Scale Robotic Dexterous Grasp Dataset for General Objects Based on Simulation},
                author = {Ruicheng Wang and Jialiang Zhang and Jiayi Chen and Yinzhen Xu and Puhao Li and Tengyu Liu and He Wang},
                journal={arXiv preprint arXiv:2210.02697},
                year = {2022}
              }
GraspNeRF: Multiview-based 6-DoF Grasp Detection for
Transparent and Specular Objects Using Generalizable NeRF
Qiyu Dai*, Yan Zhu*, Yiran Geng, Ciyu Ruan, Jiazhao Zhang,
He Wang†
              @article{dai2022graspnerf,
                title={GraspNeRF: Multiview-based 6-DoF Grasp Detection for Transparent and Specular Objects Using Generalizable NeRF},
                author={Dai, Qiyu and Zhu, Yan and Geng, Yiran and Ruan, Ciyu and Zhang, Jiazhao and Wang, He},
                journal={arXiv preprint arXiv:2210.06575},
                year={2022}
              }
A Laplace-inspired Distribution on SO(3) for Probabilistic
Rotation Estimation
              @inproceedings{
                yin2023a,
                title={A Laplace-inspired Distribution on {SO}(3) for Probabilistic Rotation Estimation},
                author={Yingda Yin and Yang Wang and He Wang and Baoquan Chen},
                booktitle={The Eleventh International Conference on Learning Representations },
                year={2023},
                url={https://openreview.net/forum?id=Mvetq8DO05O}
              }
Tracking and Reconstructing Hand Object Interactions from
Point Cloud Sequences in the Wild
Jiayi Chen*, Mi Yan*, Jiazhao Zhang, Yenzhen Xu, Xiaolong
Li, Yijia Weng, Li Yi, Shuran Song,
He Wang†
              @article{chen2022tracking,
                title={Tracking and Reconstructing Hand Object Interactions from Point Cloud Sequences in the Wild},
                author={Chen, Jiayi and Yan, Mi and Zhang, Jiazhao and Xu, Yinzhen and Li, Xiaolong and Weng, Yijia and Yi, Li and Song, Shuran and Wang, He},
                journal={arXiv preprint arXiv:2209.12009},
                year={2022}
              }
Domain Randomization-Enhanced Depth Simulation and
Restoration for Perceiving and Grasping Specular and
Transparent Objects
              @article{dai2022domain,
                title={Domain Randomization-Enhanced Depth Simulation and Restoration for Perceiving and Grasping Specular and Transparent Objects},
                author={Dai, Qiyu and Zhang, Jiyao and Li, Qiwei and Wu, Tianhao and Dong, Hao and Liu, Ziyuan and Tan, Ping and Wang, He},
                journal={arXiv preprint arXiv:2208.03792},
                year={2022}
              }
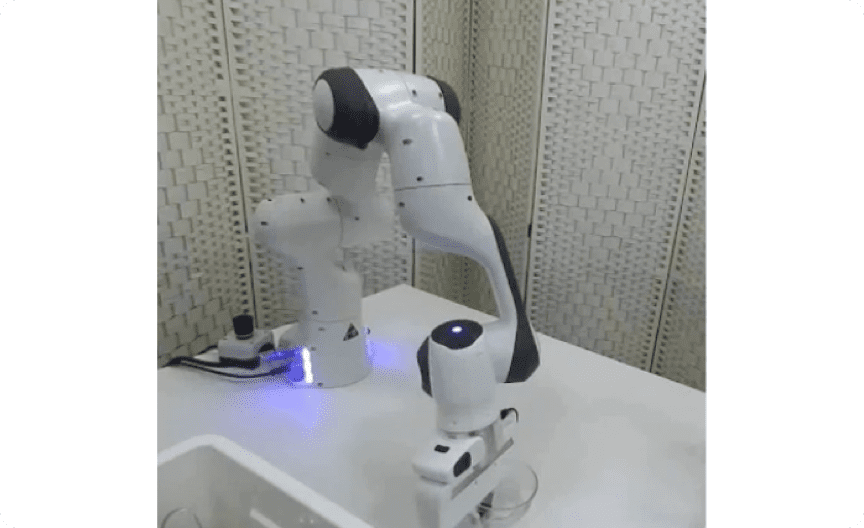
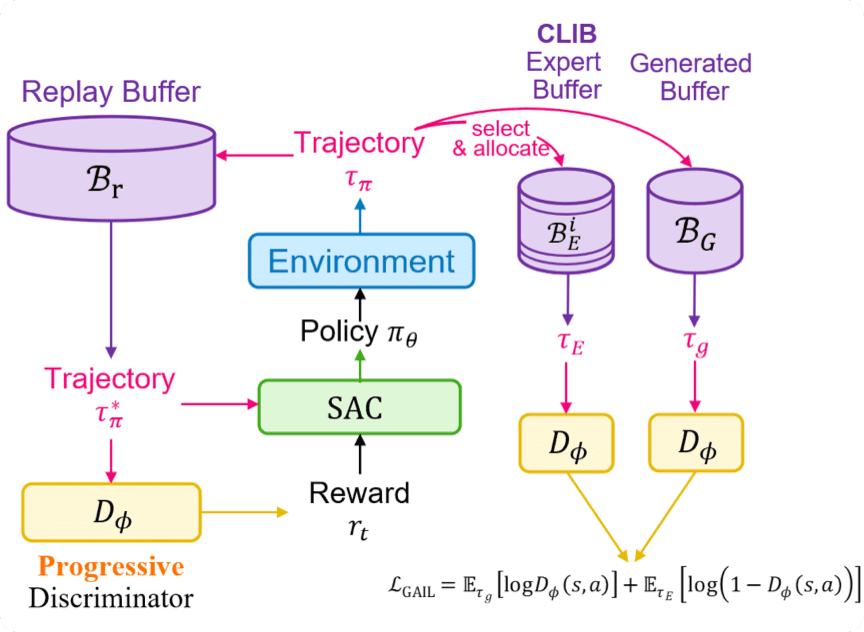
Learning Category-Level Generalizable Object Manipulation
Policy via Generative Adversarial Self-Imitation Learning
from Demonstrations
Hao Shen*, Weikang Wan*,
He Wang†
Robotics and Automation Letters (RA-L) and IROS 2022
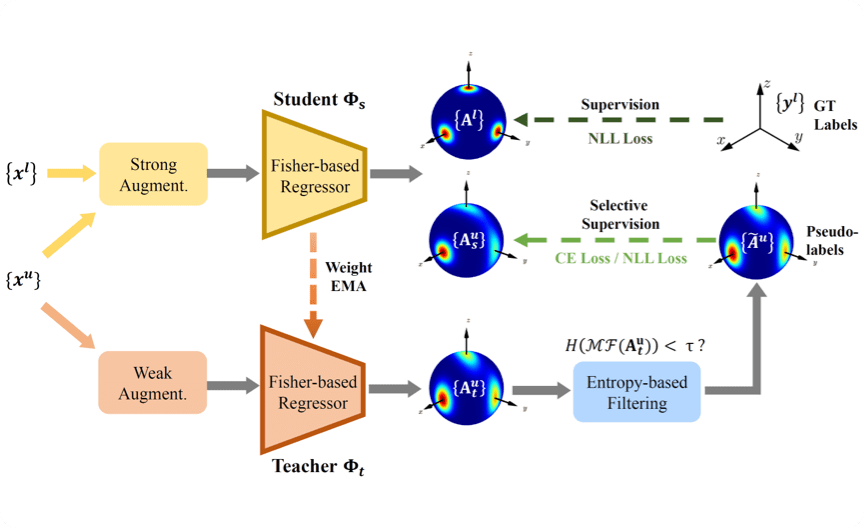
              @article{yin2022fishermatch,
                title={FisherMatch: Semi-Supervised Rotation Regression via Entropy-based Filtering},
                author={Yin, Yingda and Cai, Yingcheng and Wang, He and Chen, Baoquan},
                journal={arXiv preprint arXiv:2203.15765},
                year={2022}
              }
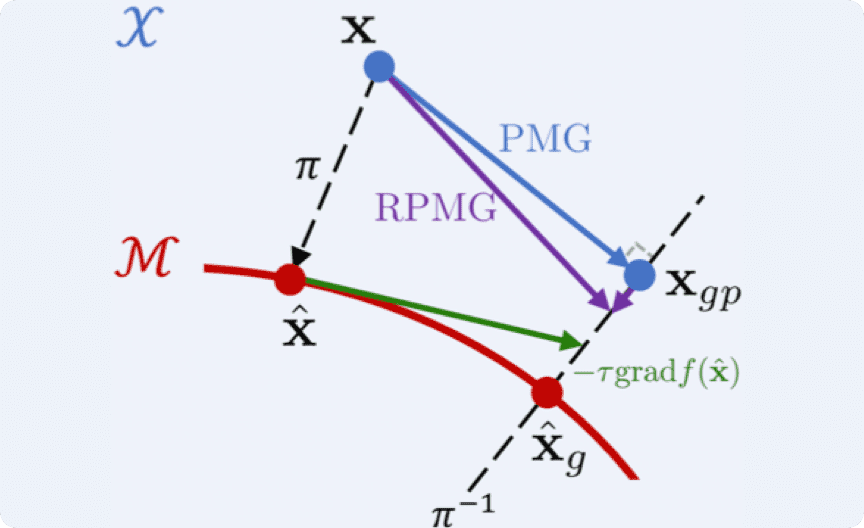
Projective Manifold Gradient Layer for Deep Rotation
Regression
              @article{chen2021projective,
                title={Projective Manifold Gradient Layer for Deep Rotation Regression},
                author={Chen, Jiayi and Yin, Yingda and Birdal, Tolga and Chen, Baoquan and Guibas, Leonidas and Wang, He},
                journal={arXiv preprint arXiv:2110.11657},
                year={2021}
              }
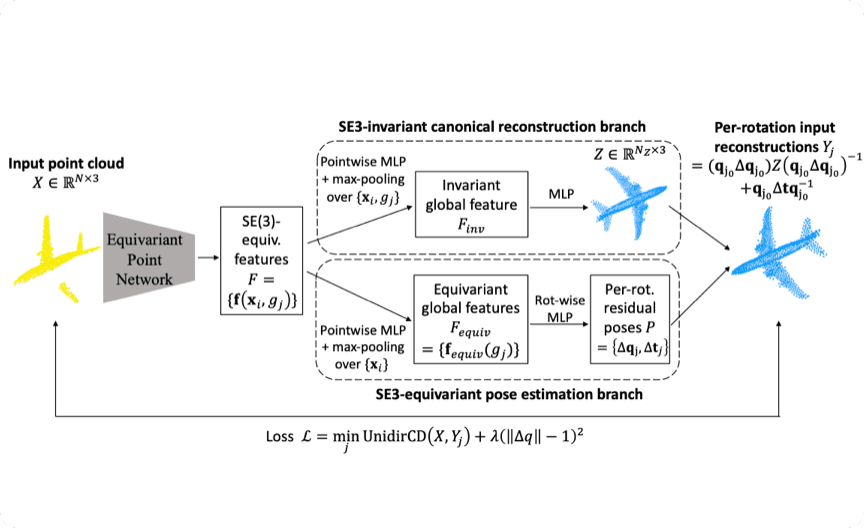
Leveraging SE(3) Equivariance for Self-supervised
Category-Level Object Pose Estimation from Point Clouds
Xiaolong Li, Yijia Weng, Li Yi, Leonidas J. Guibas, A. Lynn
Abbott, Shuran Song,
He Wang†
              @article{li2021leveraging,
                title={Leveraging SE (3) Equivariance for Self-supervised Category-Level Object Pose Estimation from Point Clouds},
                author={Li, Xiaolong and Weng, Yijia and Yi, Li and Guibas, Leonidas J and Abbott, A and Song, Shuran and Wang, He},
                journal={Advances in Neural Information Processing Systems},
                volume={34},
                year={2021}
              }
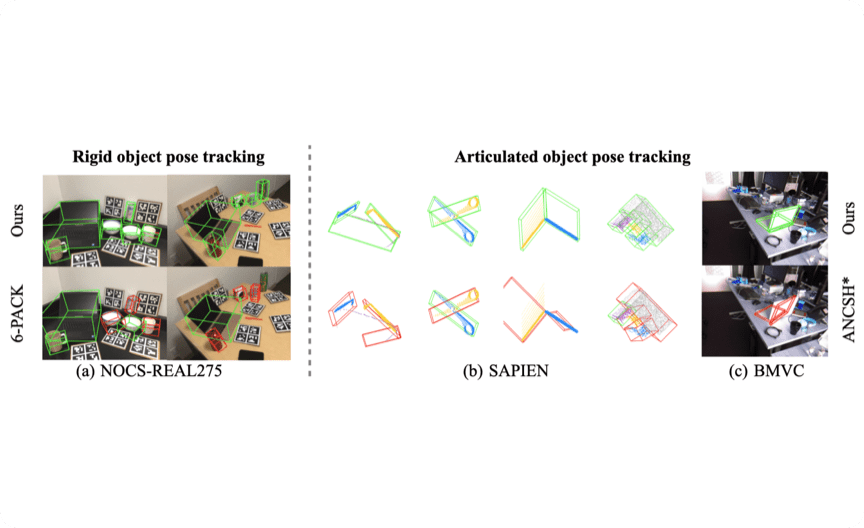
CAPTRA: CAtegory-level Pose Tracking for Rigid and
Articulated Objects from Point Clouds
Yijia Weng*,
He Wang*†, Qiang Zhou, Yuzhe Qin, Yueqi Duan, Qingnan Fan, Baoquan
Chen, Hao Su, Leonidas J. Guibas
              @article{weng2021captra,
                title={CAPTRA: CAtegory-level Pose Tracking for Rigid and Articulated Objects from Point Clouds},
                author={Weng, Yijia and Wang, He and Zhou, Qiang and Qin, Yuzhe and Duan, Yueqi and Fan, Qingnan and
                        Chen, Baoquan and Su, Hao and Guibas, Leonidas J},
                journal={arXiv preprint arXiv:2104.03437},
                year={2021}
              }
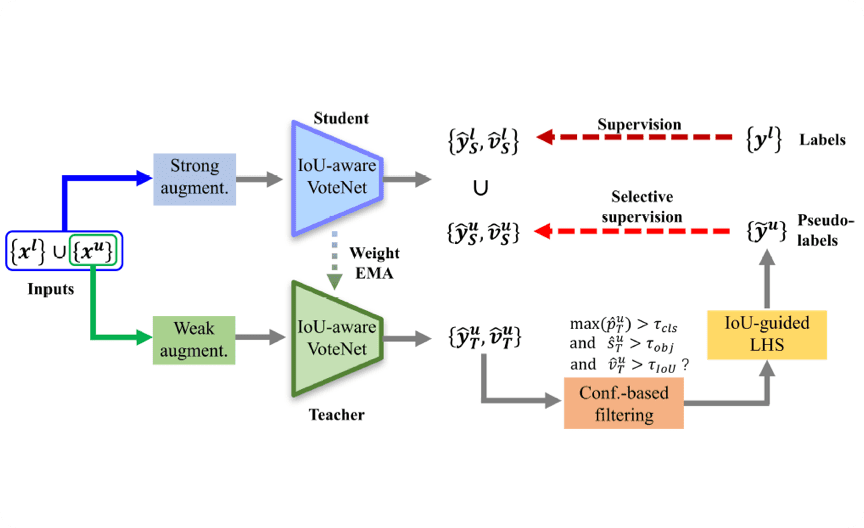
3DIoUMatch: Leveraging IoU Prediction for Semi-Supervised 3D
Object Detection
He Wang*, Yezhen Cong*, Or Litany, Yue Gao, Leonidas
J. Guibas
              @inproceedings{wang20213dioumatch,
                title={3DIoUMatch: Leveraging iou prediction for semi-supervised 3d object detection},
                author={Wang, He and Cong, Yezhen and Litany, Or and Gao, Yue and Guibas, Leonidas J},
                booktitle={Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition},
                pages={14615--14624},
                year={2021}
              }
              @misc{duan2020curriculum,
                title={Curriculum DeepSDF},
                author={Yueqi Duan and Haidong Zhu and He Wang and Li Yi and Ram Nevatia and Leonidas J. Guibas},
                year={2020},
                eprint={2003.08593},
                archivePrefix={arXiv},
                primaryClass={cs.CV}
              }
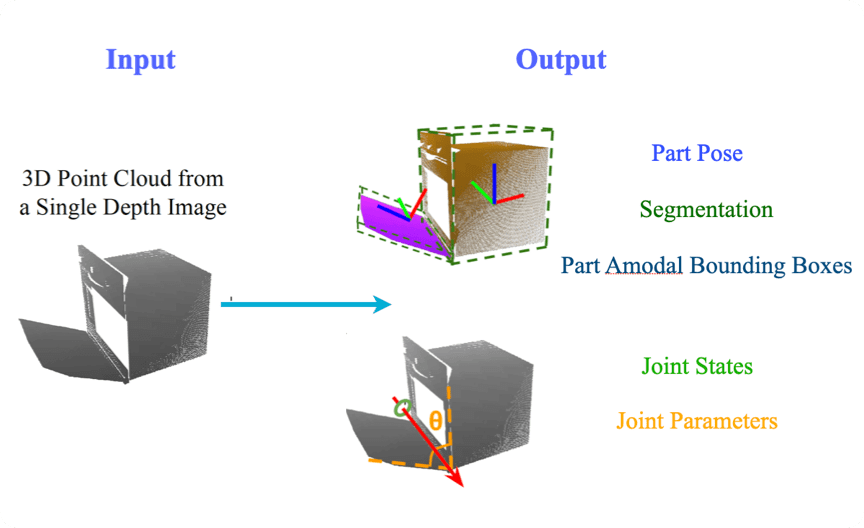
Category-Level Articulated Object Pose Estimation
He Wang*, Xiaolong Li*, Li Yi, Leonidas J. Guibas, A.
Lynn Abbott, Shuran Song†
              @article{li2019category,
                title={Category-Level Articulated Object Pose Estimation},
                author={Li, Xiaolong and Wang, He and Yi, Li and Guibas, Leonidas and Abbott, A Lynn and Song, Shuran},
                journal={arXiv preprint arXiv:1912.11913},
                year={2019}
              }
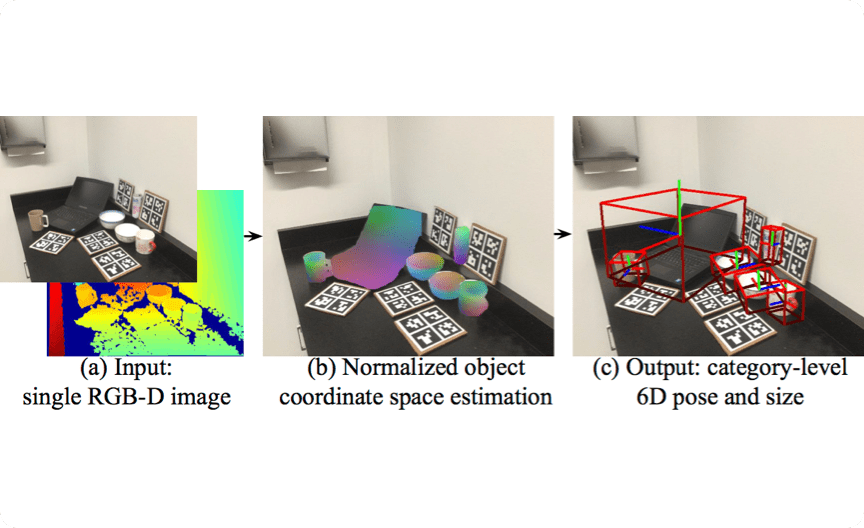
Normalized Object Coordinate Space for Category-Level 6D
Object Pose and Size Estimation
He Wang, Srinath Sridhar, Jingwei Huang, Julien
Valentin, Shuran Song, Leonidas J. Guibas
              @inproceedings{wang2019normalized,
                title={Normalized object coordinate space for category-level 6d object pose and size estimation},
                author={Wang, He and Sridhar, Srinath and Huang, Jingwei and Valentin, Julien and Song, Shuran and Guibas, Leonidas J},
                booktitle={Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition},
                pages={2642--2651},
                year={2019}
              }
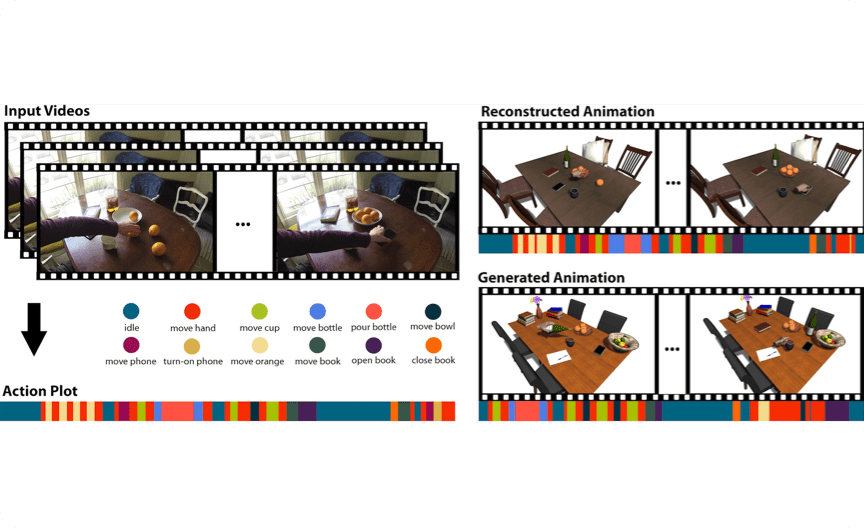
Learning a Generative Model for Multi-Step Human-Object
Interactions from Videos
He Wang*, Soeren Pirk*, Ersin Yumer, Vladimir Kim, Ozan Sener,
Srinath Sridhar, Leonidas J. Guibas
Deputy Director, Embodied Intelligence Group, Artificial
Intelligence Standardization Technical Committee, Ministry of
Industry and Information Technology (MIIT), China